Perché Googlebot può risultare bloccato anche se il robots.txt è in ordine? Perché tra Google e il sito possono esserci una CDN, un firewall applicativo o un sistema di gestione dei bot, che possono rispondere con un errore, una verifica anti-robot o un limite di richieste prima che la visita arrivi al server. Google scrive che un blocco di questo tipo può impedire al sito di comparire nei risultati e che può essere difficile da controllare, perché avviene sulla CDN.
Googlebot bloccato in breve
- Dove nasce: regole del firewall, limiti di richieste, verifiche anti-robot, blocchi per Paese, impostazioni sui bot di intelligenza artificiale.
- 403 e altri 4xx: le pagine escono dall’indice nel tempo; non servono a rallentare la scansione.
- 429 e 503: il modo corretto per chiedere una pausa, per qualche ora o uno o due giorni.
- Pagina di errore con codice 200: per Google è un errore soft, che definisce grave.
- Più crawler da ammettere: Googlebot, ma anche AdsBot e Storebot se il sito usa Google Ads o Shopping.
- Diagnosi: Statistiche di scansione ed eventi del firewall; le richieste bloccate non compaiono nei log del server.
- Cloudflare: dal 15 settembre 2026 l’opzione "Block" sui bot di addestramento ferma anche Googlebot.
Perché Googlebot risulta bloccato da una CDN o da un firewall?
Perché riconoscono Googlebot come traffico automatico e gli applicano le regole pensate per i bot indesiderati. Nel dicembre 2024 Google ha descritto il caso delle CDN "eccessivamente protettive": gli indirizzi dei suoi crawler possono finire nella lista di blocco del firewall applicativo anche in automatico, senza che il proprietario del sito lo sappia.
La stessa analisi ricorda un vantaggio delle CDN: quando Google riconosce che un sito è servito da una CDN, alza la soglia oltre la quale rallenta la scansione. Quando si pubblicano molti URL insieme, con la cache della CDN ancora vuota, la scansione può restare alta per alcuni giorni e pesare sul server d’origine.
Audit SEO
Audit SEO tecnico per siti ed e-commerce, con gli interventi ordinati per impatto.
Blocco duro e blocco morbido per Google
La differenza tra blocco duro e blocco morbido dipende dalla risposta che riceve Googlebot. La guida di Google ai codici di stato e due articoli del suo blog, del 2023 e del 2024, descrivono effetti molto diversi.
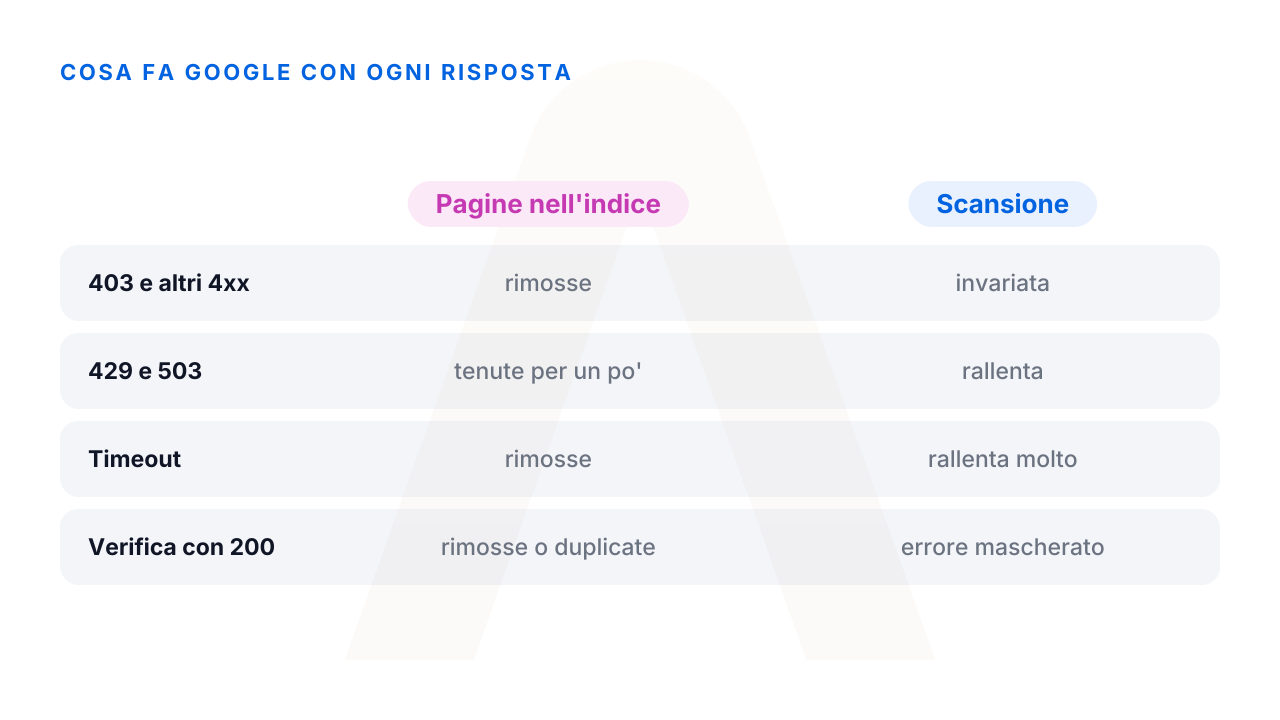
- 403, 404 e altri 4xx: Google non usa il contenuto e gli URL già indicizzati vengono rimossi. Questi codici non riducono la frequenza di scansione, fatta eccezione per il 429.
- 429 e 503: Google li legge come server sovraccarico e rallenta. Gli URL restano nell’indice per un po’, poi vengono eliminati se l’errore prosegue.
- Timeout di rete: sono errori duri, che rimuovono gli URL e possono ridurre molto la scansione.
- Messaggio di errore con codice 200: Google lo chiama errore soft e lo definisce grave. Se lo riconosce come errore toglie l’URL; altrimenti le pagine che mostrano tutte lo stesso messaggio rischiano di essere scartate come duplicati.
Google chiarisce anche un equivoco sulle verifiche del tipo "sei un essere umano?": i suoi crawler sono convinti di non esserlo. La raccomandazione è servire ai client automatici un 503 mentre la verifica è in corso, così il contenuto non viene tolto dall’indice.
Quale codice di stato usare per rallentare Googlebot?
Un 429, un 503 o un errore 500, per qualche ora o al massimo uno o due giorni. Nel febbraio 2023 Google ha segnalato di aver notato proprietari di siti e alcune CDN che usavano 404 e altri 4xx per ridurre la scansione. Ha ricordato che tutti i codici 4xx diversi da 429 fanno rimuovere i contenuti dalla Ricerca.
Lo stesso articolo ricorda che un robots.txt servito con un 4xx viene inoltre trattato come inesistente, quindi le sue regole smettono di valere.
Oltre uno o due giorni un URL che risponde sempre 429 o 503 può uscire dall’indice, e il rallentamento vale per l’intero nome host, anche per le pagine che rispondono normalmente. La pagina di Google sulla riduzione della scansione avverte anche di un effetto commerciale: prezzi e disponibilità si aggiornano più lentamente nella Ricerca e le campagne Google Ads possono essere annullate o messe in pausa. Non esiste più un comando in Search Console per chiedere meno visite: Google lo ha tolto l’8 gennaio 2024.
I crawler di Google da ammettere nel firewall
I crawler di Google da ammettere nel firewall sono più di uno. Google divide i suoi crawler in tre famiglie, ciascuna con un proprio file di indirizzi IP e un proprio schema di nomi DNS. Un’eccezione costruita solo su Googlebot lascia fuori crawler che contano per le campagne e per lo Shopping.
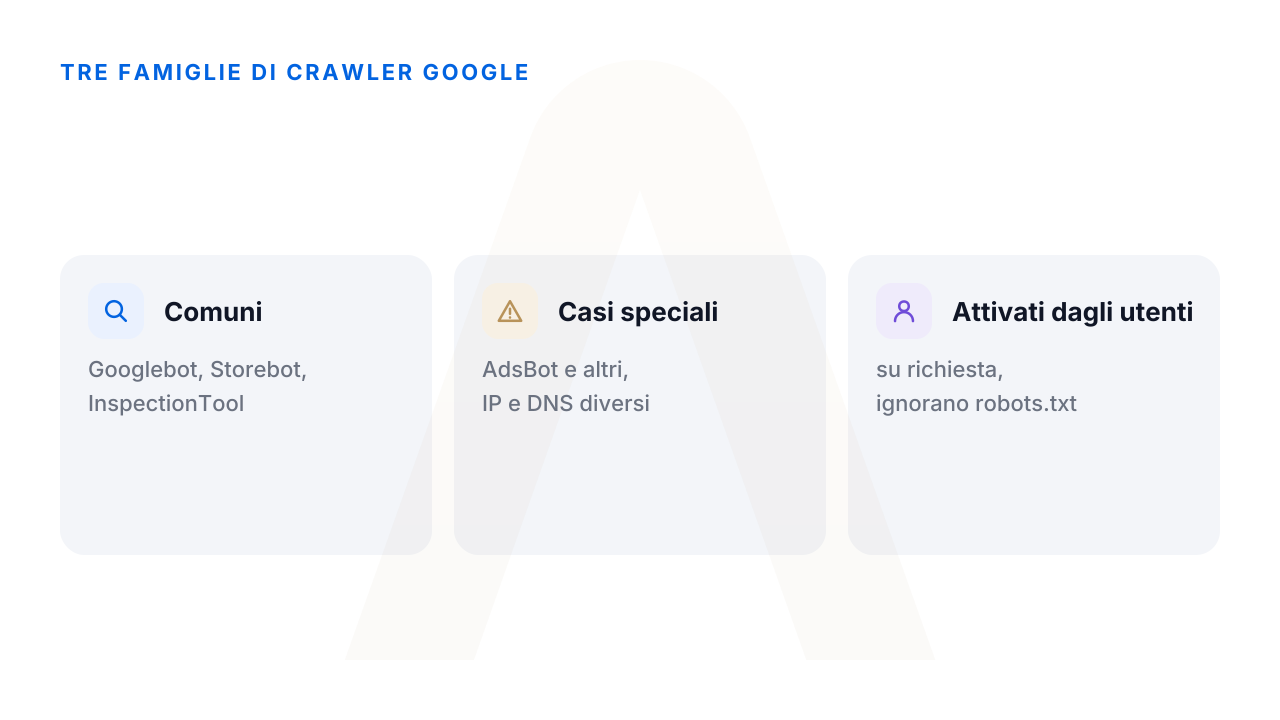
- Crawler comuni: Googlebot nelle sue varianti, Storebot-Google per le superfici di Shopping, Google-InspectionTool per i test di Search Console. Rispettano sempre il robots.txt; il file è common-crawlers.json.
- Crawler per casi speciali: AdsBot-Google e altri, con indirizzi diversi, nomi DNS del tipo rate-limited-proxy e file special-crawlers.json.
- Fetcher attivati dagli utenti: strumenti che agiscono su richiesta di una persona e in genere ignorano il robots.txt.
Due dettagli evitano errori comuni. Dall’11 febbraio 2026 i file degli indirizzi stanno in un nuovo percorso, /crawling/ipranges/; il vecchio funziona ancora per ora, ma Google consiglia di aggiornare i collegamenti, e un elenco copiato a mano invecchia. Google-Extended, il controllo sull’uso dei contenuti per i modelli Gemini, è solo un token del robots.txt senza uno user agent proprio, quindi nel traffico non compare e non si può bloccare o ammettere nel firewall.
Cosa cambia su Cloudflare con i controlli sui bot di intelligenza artificiale?
Su Cloudflare le regole sui bot di intelligenza artificiale sono cambiate più volte in poco tempo. Il 1° luglio 2025 Cloudflare ha reso predefinito il blocco dei crawler di intelligenza artificiale. Il 1° luglio 2026 ha annunciato che dal 15 settembre chi bloccava i bot di addestramento avrebbe bloccato anche i crawler misti, Googlebot compreso. Il 15 settembre 2026 ha aggiunto un’opzione per restare nella ricerca rifiutando l’addestramento.
| Impostazione | Effetto su Googlebot |
|---|---|
| Disallow AI Training | Googlebot resta ammesso per la ricerca; per Google la preferenza passa da un Disallow su Google-Extended nel robots.txt |
| Block | ferma anche Googlebot, Bingbot e Applebot, ricerca compresa |
| Block on pages with ads | ferma i crawler misti sulle pagine con annunci |
Oltre ai controlli sull’intelligenza artificiale, la documentazione di Cloudflare indica altri punti in cui Googlebot può essere fermato. Il Bot Fight Mode del piano Free non si scavalca con le regole del firewall: per creare eccezioni Cloudflare rimanda a Super Bot Fight Mode. Le regole di limitazione delle richieste, avverte Cloudflare, possono incidere sulla SEO se si applicano ai bot verificati.
Dal 1° luglio 2026, infine, l’etichetta "verificato" non significa più ammesso per impostazione predefinita: conta la categoria consentita. Sulla CDN si impostano anche i security headers, che però danno istruzioni al browser e non fermano le richieste dei crawler.
Come si configurano le eccezioni per i bot verificati?
Sull’identità verificata del bot, mai sul solo user agent, che chiunque può imitare. I fornitori principali offrono un segnale di bot verificato da usare nelle regole, con comportamenti diversi documentati nelle rispettive guide.
- Cloudflare: il campo cf.client.bot identifica i bot noti e verificati; l’esempio ufficiale sfida il traffico di alcuni Paesi lasciando passare Googlebot e gli altri motori di ricerca.
- Fastly: per escludere un bot dalle verifiche anti-robot va inserito esplicitamente nella condizione della regola, per esempio escludendo i client con il segnale di bot verificato.
- AWS WAF Bot Control: non blocca i bot verificati, ma li riconosce dall’IP di origine della richiesta; dietro un proxy o un bilanciatore serve una regola precedente che usi l’IP inoltrato.
Web Bot Auth, lo standard in bozza per firmare le richieste dei bot, è in prova da Google da maggio 2026 con alcuni agenti di intelligenza artificiale e copre solo una parte delle loro richieste. Per questo Google chiede di tenere come base la verifica con IP, DNS inverso e user agent.
Il blocco per Paese o i redirect per Paese creano problemi a Googlebot?
Sì, se riguardano gli Stati Uniti. Google scrive che i suoi crawler escono soprattutto da indirizzi IP statunitensi e che possono provare altri Paesi se rilevano un blocco degli Stati Uniti. Nella guida ai siti multiregionali aggiunge che Googlebot in genere arriva dagli Stati Uniti senza indicare una lingua, quindi può non trovare tutte le varianti adattate in automatico; sconsiglia inoltre di adattare i contenuti in base all’IP.
Un sito italiano che blocca gli Stati Uniti o li reindirizza a un’altra versione rischia quindi che Googlebot veda un errore o una sola versione del sito. Anche Cloudflare avverte che le regole personalizzate basate sul Paese possono bloccare i bot noti e incidere sulla SEO. Per le versioni linguistiche la strada corretta è l’hreflang, senza redirect automatici.
Come si capisce se c’è un Googlebot bloccato?
Incrociando i report di Search Console con gli eventi del firewall o della CDN. Nel report Statistiche di scansione i segnali sono l’aumento di errori 4xx e 5xx, di pagine non raggiungibili e di timeout, oltre allo stato dell’host sulla connettività del server. Tra gli stati del report Indicizzazione delle pagine compare lo stato dedicato al 403, l’accesso non autorizzato: l’articolo sulle pagine non indicizzate lo spiega insieme agli altri stati.
Il test dal vivo del Controllo URL mostra lo screenshot della pagina: una pagina vuota, un errore o una verifica anti-robot indicano un blocco sulla CDN. Il test però usa Google-InspectionTool e controlla un solo URL, quindi può riuscire mentre una limitazione basata sui volumi tiene Googlebot bloccato. L’errore "Carico host superato" (Hostload exceeded nell’interfaccia inglese) indica invece, secondo la guida al Controllo URL, che il sito sembra al limite della capacità stimata da Google.
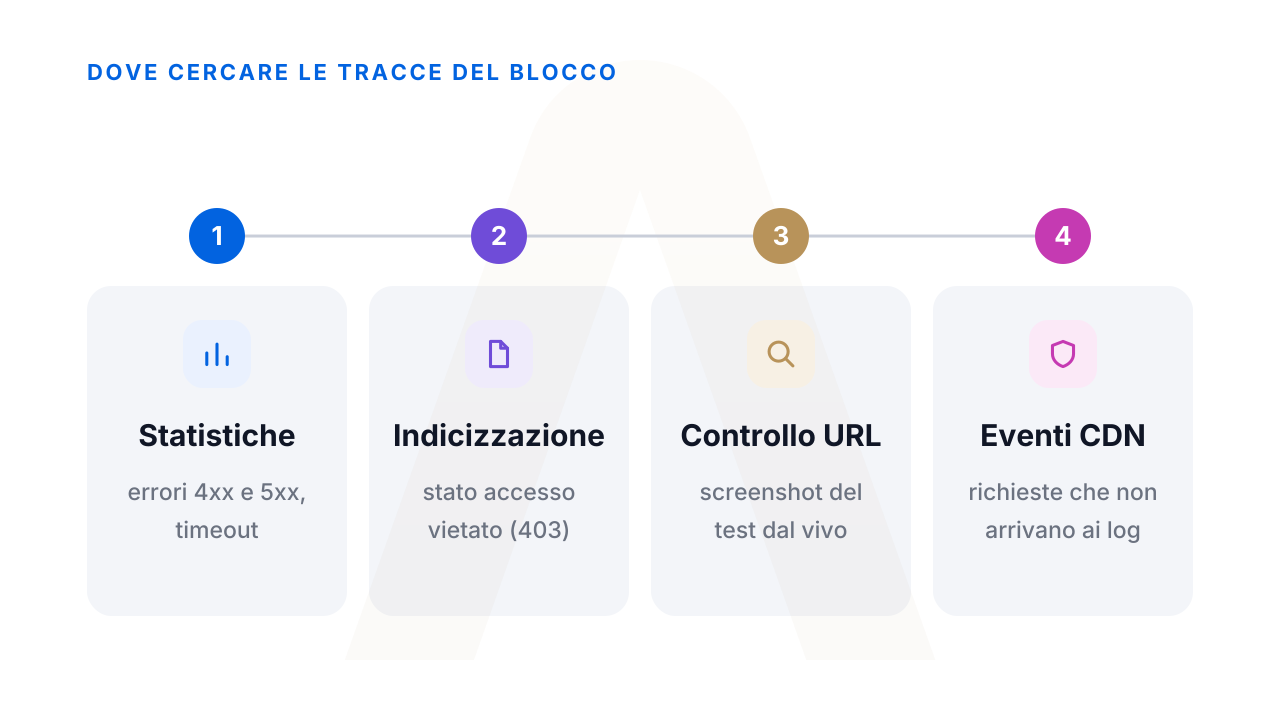
Il punto più trascurato riguarda i log: Google precisa che le richieste classificate come "pagina non raggiungibile" non arrivano al server e non compaiono nei suoi log. Vanno cercate negli eventi di sicurezza della CDN. L’articolo sul crawl budget descrive la verifica dei veri Googlebot nei log e le metriche da calcolare.
Googlebot bloccato: l’elenco delle regole che possono fermarlo
Un Googlebot bloccato si risolve partendo dalle Statistiche di scansione e dagli eventi del firewall degli ultimi giorni. Il passaggio successivo è elencare ogni regola che può toccare i crawler di Google: firewall, limiti di richieste, gestione dei bot, controlli sull’intelligenza artificiale, blocchi per Paese, moduli anti-bot sul server d’origine. Per ogni regola verifica che l’eccezione si basi sui bot verificati e comprenda AdsBot e Storebot se servono. Se devi rallentare Google, usa 429 o 503 per poche ore.
Quando Googlebot risulta bloccato, il controllo delle regole di scansione rientra in un audit SEO tecnico: il consulente individua regole e codici da cambiare, il reparto IT o il fornitore della CDN li applica, il consulente verifica il risultato in Search Console. Sapere quali CDN e firewall proteggono il sito è il primo passo: puoi segnalarceli per una verifica delle regole che toccano Googlebot.
Domande frequenti su Googlebot bloccato
Come capisco se Googlebot è bloccato dal firewall o dalla CDN?
Controlla nelle Statistiche di scansione errori, timeout e pagine non raggiungibili, nel report Indicizzazione delle pagine lo stato 403 e lo screenshot del test dal vivo nel Controllo URL. Poi cerca le richieste di Google negli eventi di sicurezza della CDN.
Un errore 403 a Googlebot fa uscire le pagine da Google?
Sì. Ogni codice 4xx diverso dal 429 porta alla rimozione dei contenuti dalla Ricerca e non riduce la frequenza di scansione: per chiedere una pausa temporanea a Googlebot servono un 429 o un 503, per poche ore.
Qual è il codice giusto per rallentare Googlebot?
Un 429, un 503 o un 500, per qualche ora o al massimo uno o due giorni. Mantenuti più a lungo fanno uscire gli URL dall’indice. I codici 403 e 404 non servono allo scopo: tolgono le pagine senza rallentare la scansione.
Cloudflare blocca Googlebot?
Non per impostazione predefinita. Può farlo se si sceglie Block nel controllo sui bot di addestramento, con Bot Fight Mode, con regole del firewall, limiti di richieste o blocchi per Paese che non escludono i bot verificati.
Bloccare i bot AI blocca anche Googlebot?
Dipende dall’impostazione. Su Cloudflare, dal 15 settembre 2026, Disallow AI Training lascia passare Googlebot per la ricerca, mentre Block lo ferma. Google-Extended, nel robots.txt, riguarda i modelli Gemini e lascia invariata la Ricerca.
Posso bloccare gli Stati Uniti senza problemi SEO?
È rischioso: i crawler di Google escono soprattutto da IP statunitensi e provano altri Paesi solo se rilevano il blocco. Le regole per Paese, inoltre, possono fermare anche i bot noti: se servono, vanno escluse le richieste dei bot verificati.
Come si ammette Googlebot in un firewall in modo sicuro?
Con le regole basate sui bot verificati tramite IP, DNS inverso o firma, mai sul solo user agent. Se il sito usa Google Ads o Shopping vanno ammessi anche AdsBot e Storebot.
Cosa significa Hostload exceeded nel Controllo URL?
Nell’interfaccia italiana l’errore si chiama Carico host superato: il sito sembra al massimo della capacità stimata da Google per le richieste di scansione o di ispezione. Google non esegue il test finché il carico non scende.
Iscriviti alla newsletter
Ricevi la newsletter via email. Puoi disiscriverti quando vuoi.