Come sono messi i siti delle aziende italiane sulla SEO tecnica? Su 3.879 homepage analizzate a novembre 2026, il 30,7% non ha un H1, il 17,0% non ha una meta description e l'8,6% risponde su due versioni del dominio senza redirect. Il 9,4% blocca almeno un crawler AI e in un caso su tre il blocco arriva dalle impostazioni di Cloudflare.
Lo studio in breve
- Campione: 3.879 aziende con sito .it e Partita IVA valida in homepage
- Dati raccolti: dal 5 al 7 novembre 2026
- Homepage senza H1: 30,7%
- Homepage senza meta description: 17,0%
- Tag canonical presente: 75,7%
- Almeno un crawler AI bloccato: 9,4%
- File llms.txt senza generatore automatico: 8,1%
- Rapporto completo, dati e codice: Zenodo, DOI 10.5281/zenodo.24112421
La SEO tecnica è l'insieme degli interventi sul codice e sull'infrastruttura che permettono a Google e ai crawler AI di scansionare, capire e indicizzare le pagine di un sito. Lo studio ne misura le basi sulla homepage: title, H1, meta description, canonical, sitemap, redirect, dati strutturati e regole per i crawler AI. Velocità e Core Web Vitals non rientrano nell'analisi.
Come è stato costruito lo studio?
Lo studio parte dai siti più visitati misurati dal Chrome UX Report di Google e tiene solo le aziende italiane con un dominio .it e una Partita IVA valida pubblicata in homepage. Da 15.627 origini .it si arriva a 3.879 aziende, dopo aver escluso enti pubblici, associazioni, fondazioni e testate giornalistiche.
Per ogni sito abbiamo controllato tre gruppi di elementi: le basi on-page (title, meta description, H1, canonical, hreflang e dati strutturati), la scansione (robots.txt, sitemap XML, redirect verso HTTPS e verso la versione principale del dominio) e i segnali per gli agenti AI, cioè le regole per i crawler AI nel robots.txt e il file llms.txt.
Per verificare il metodo abbiamo controllato a mano 100 siti estratti a caso: 91 sono aziende, 6 non lo sono e 3 restano dubbi. Abbiamo poi aperto 170 homepage con un browser vero, che esegue anche il JavaScript, e i risultati cambiano di uno o due siti per elemento. Il rapporto completo, con intervalli di confidenza, tabelle e script, è pubblicato su Zenodo con DOI 10.5281/zenodo.24112421.
Quali errori di base hanno i siti delle aziende italiane?
La lacuna più diffusa riguarda l'H1: manca nel 30,7% delle homepage, mentre nel 18,3% ce n'è più di uno. Seguono la meta description, assente nel 17,0% dei casi, e il tag canonical, che manca in un sito su quattro.
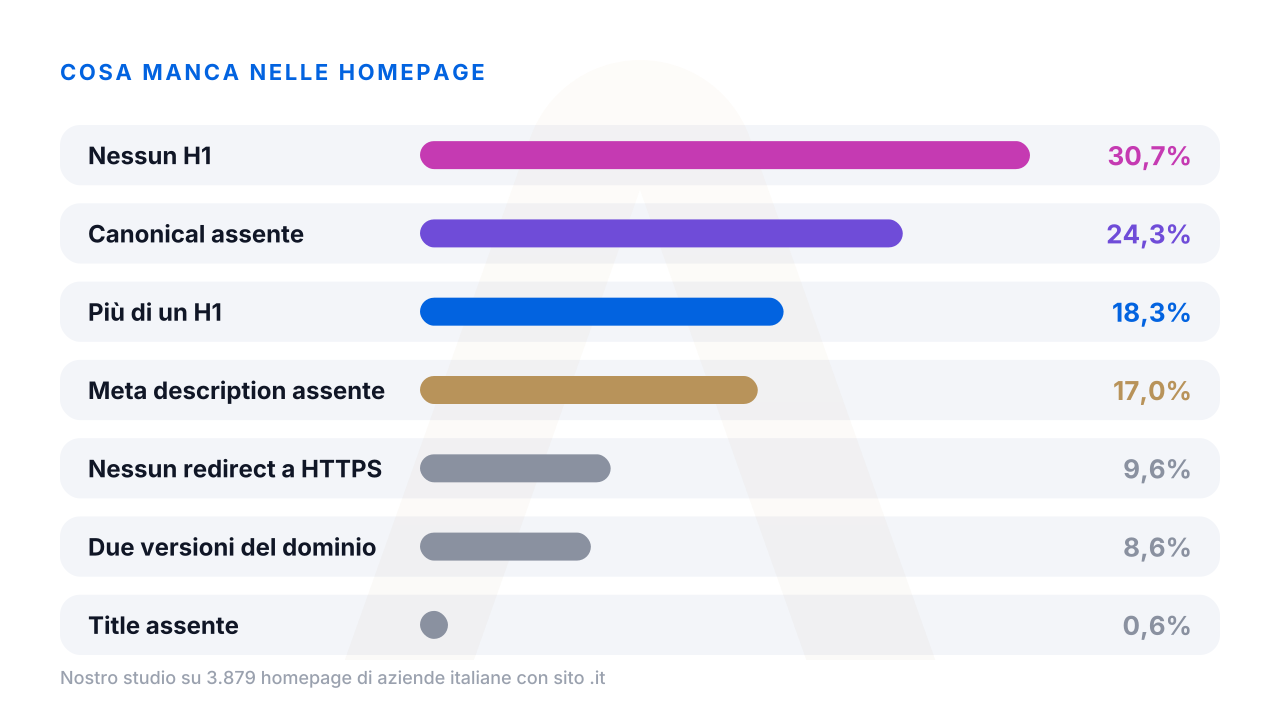
La tabella riassume la presenza degli elementi on-page di base nelle 3.879 homepage del campione.
| Elemento | Siti | Quota |
|---|---|---|
| Title assente | 23 su 3.879 | 0,6% |
| Meta description assente | 661 su 3.879 | 17,0% |
| Nessun H1 | 1.180 su 3.838 | 30,7% |
| Più di un H1 | 701 su 3.838 | 18,3% |
| Tag canonical presente | 2.905 su 3.838 | 75,7% |
| Hreflang presente | 1.091 su 3.838 | 28,4% |
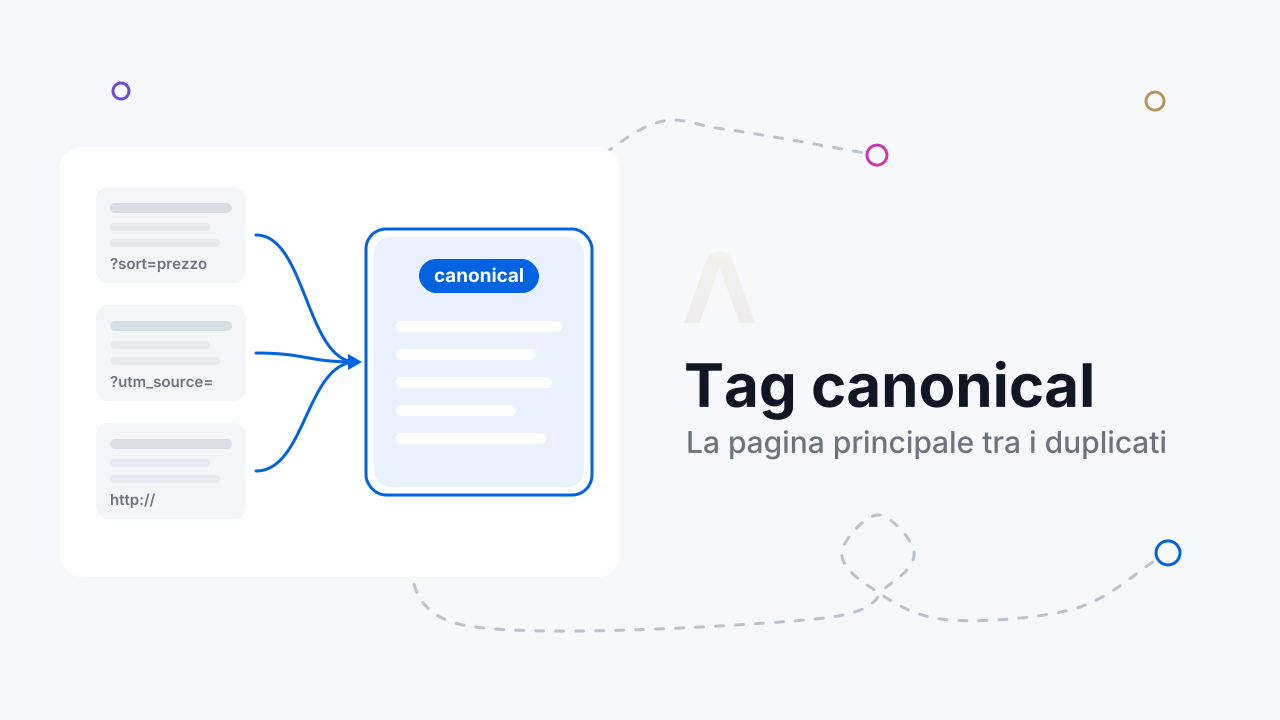
Se la meta description manca, Google compone lo snippet con il testo della pagina e l'azienda perde il controllo su cosa appare nei risultati. Il tag canonical indica a Google la versione principale di una pagina e serve soprattutto quando lo stesso contenuto è raggiungibile da più indirizzi.
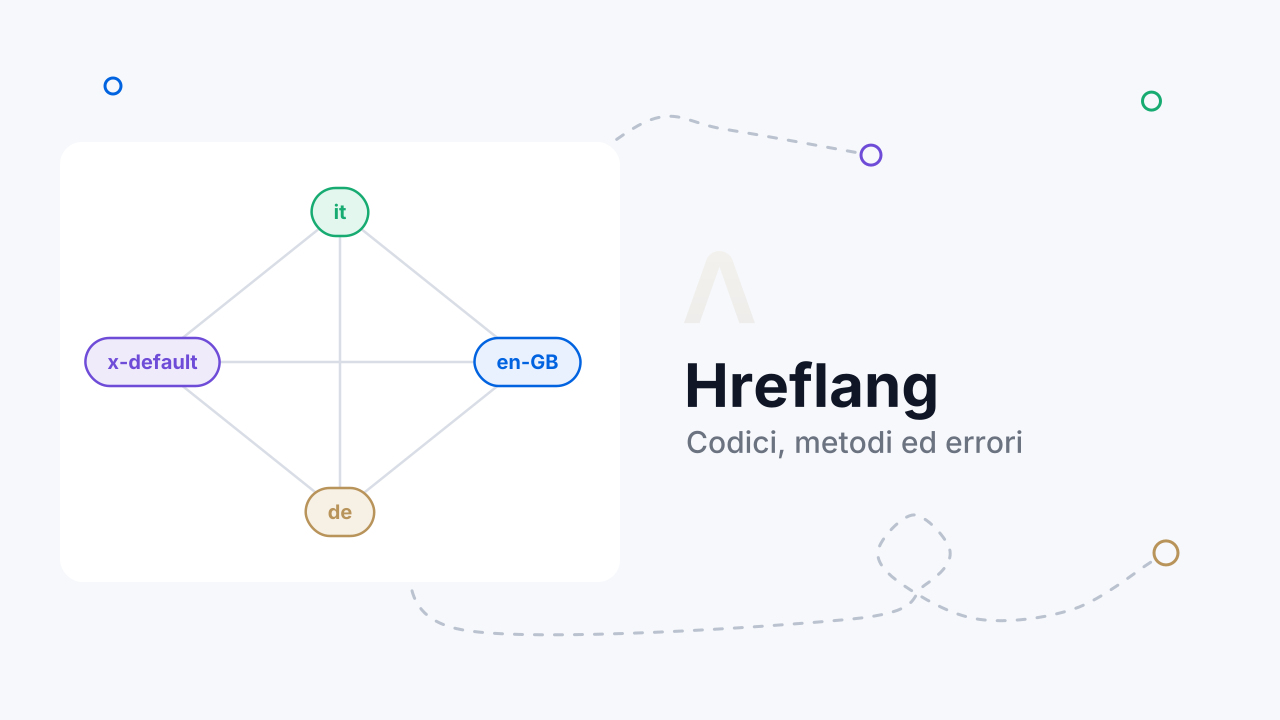
Lo studio verifica solo che gli elementi ci siano. Un canonical che punta all'indirizzo sbagliato o un hreflang senza i collegamenti reciproci tra le lingue contano comunque come presenti, quindi i siti configurati correttamente sono meno di quelli in tabella. Per i siti in più lingue la SEO internazionale parte proprio dalla verifica di hreflang e canonical su ogni versione.
Le aziende italiane usano i dati strutturati?
Due homepage su tre contengono dati strutturati in JSON-LD (66,5%) e poco più della metà descrive l'azienda con il tipo Organization o con un suo sottotipo (54,7%). LocalBusiness, il tipo pensato per chi ha una sede aperta al pubblico, compare nel 6,1% dei siti.
- WebSite nel 55,4% delle homepage
- Organization o un suo sottotipo nel 54,7%
- BreadcrumbList nel 26,9%
- LocalBusiness o un suo sottotipo nel 6,1%
- FAQPage nel 2,4%
Per le aziende con un punto vendita o uno studio questo è il numero da guardare. I dati strutturati di tipo locale permettono di indicare a Google indirizzo, orari e contatti della sede. Lavorano insieme alla scheda Google Business Profile, che resta lo strumento principale della local SEO per comparire nelle ricerche vicine.
Robots.txt, sitemap e HTTPS sono configurati bene?
Nella maggior parte dei siti sì: il 90,1% ha un robots.txt, l'81,1% una sitemap XML raggiungibile e il 90,4% reindirizza la versione HTTP su HTTPS. Le lacune riguardano i redirect e la sitemap.
Solo il 69,2% indica la sitemap XML nel robots.txt, che è il modo più semplice per farla trovare a tutti i motori di ricerca. L'8,6% risponde con status 200 sia sulla versione con www sia su quella senza, senza reindirizzare alla principale: se manca anche un canonical che indichi la versione giusta, la homepage esiste in due copie e la scelta passa a Google. Il 9,6% non reindirizza la versione HTTP su HTTPS.
Un controllo del sito trova questi problemi in pochi minuti. Durante una migrazione SEO, per esempio un cambio di dominio o di piattaforma, redirect e versione principale vanno pianificati prima di andare online.
Quante aziende bloccano i crawler AI?
Il 9,4% delle aziende blocca almeno un crawler AI con una regola dedicata nel robots.txt. Considerando solo i siti che hanno un robots.txt la quota sale al 10,4%, vicina al 10,5% rilevato da Casaleggio Associati sui robots.txt leggibili dei primi mille e-commerce italiani, anche se i due campioni sono diversi.
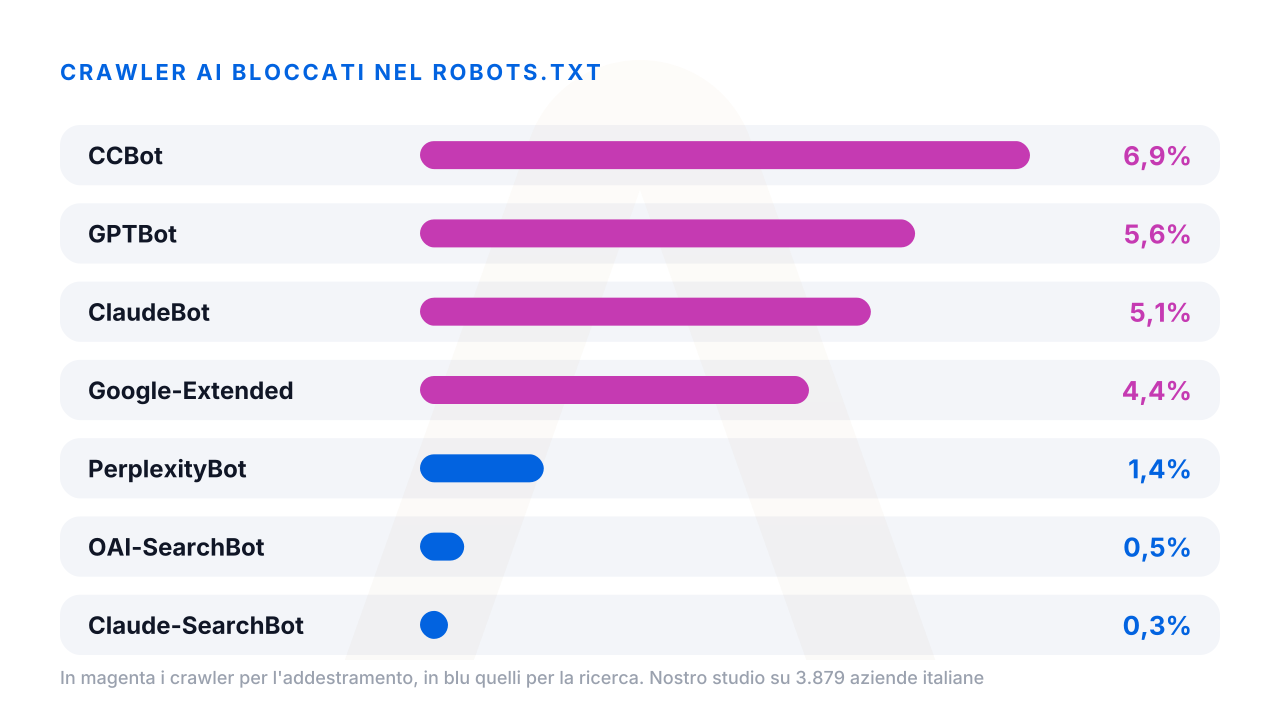
Vengono bloccati per lo più i crawler che raccolgono testi per addestrare i modelli. Quelli che servono alla ricerca e alle domande degli utenti restano quasi sempre aperti.
| Crawler | Uso dichiarato | Siti che lo bloccano |
|---|---|---|
| CCBot | Archivio Common Crawl, usato anche per l'addestramento | 6,9% |
| GPTBot | Addestramento dei modelli OpenAI | 5,6% |
| ClaudeBot | Addestramento dei modelli Anthropic | 5,1% |
| Google-Extended | Uso dei contenuti per Gemini | 4,4% |
| PerplexityBot | Indice di ricerca di Perplexity | 1,4% |
| OAI-SearchBot | Ricerca di ChatGPT | 0,5% |
| Claude-SearchBot | Ricerca di Claude | 0,3% |
OpenAI tiene separati i due usi: bloccare GPTBot indica che i contenuti non vanno usati per l'addestramento, mentre OAI-SearchBot riguarda la presenza nelle risposte di ricerca di ChatGPT. Dei 217 siti che bloccano GPTBot, 197 lasciano passare OAI-SearchBot, e in 109 casi questa combinazione arriva dal modello preimpostato da Cloudflare. Google-Extended non incide sulla Ricerca Google. Per le AI Overview conta che la pagina sia indicizzata e che Googlebot possa scansionarla: nel campione Googlebot è bloccato da 12 siti, uno con una regola dedicata e 11 con un blocco generale.
Molti di questi blocchi seguono un modello pronto. Abbiamo ricontrollato i siti con almeno un blocco e, dei 361 che hanno risposto, 112 usano il robots.txt gestito da Cloudflare: il sito lo attiva dalle impostazioni e Cloudflare aggiunge le regole per otto crawler AI. Le stesse protezioni di CDN e firewall possono fermare anche crawler che il sito vorrebbe lasciar passare, come spiegato nella guida su Googlebot bloccato e sui controlli da fare quando la scansione si interrompe.
Il file llms.txt è presente nel 23,6% dei siti, ma circa due file su tre sono generati in automatico: 420 dal modello predefinito di Shopify e 178 da un generatore dichiarato, quasi sempre un plugin come Yoast, Rank Math o All in One SEO. I file senza un generatore riconoscibile sono l'8,1% del campione.
Quanto conta la piattaforma del sito?
La piattaforma pesa molto sulle basi tecniche del sito. Su Shopify, WooCommerce e WordPress, che generano canonical e sitemap da soli, questi elementi ci sono in oltre il 93% dei siti; dove il lavoro resta allo sviluppatore, la copertura scende.
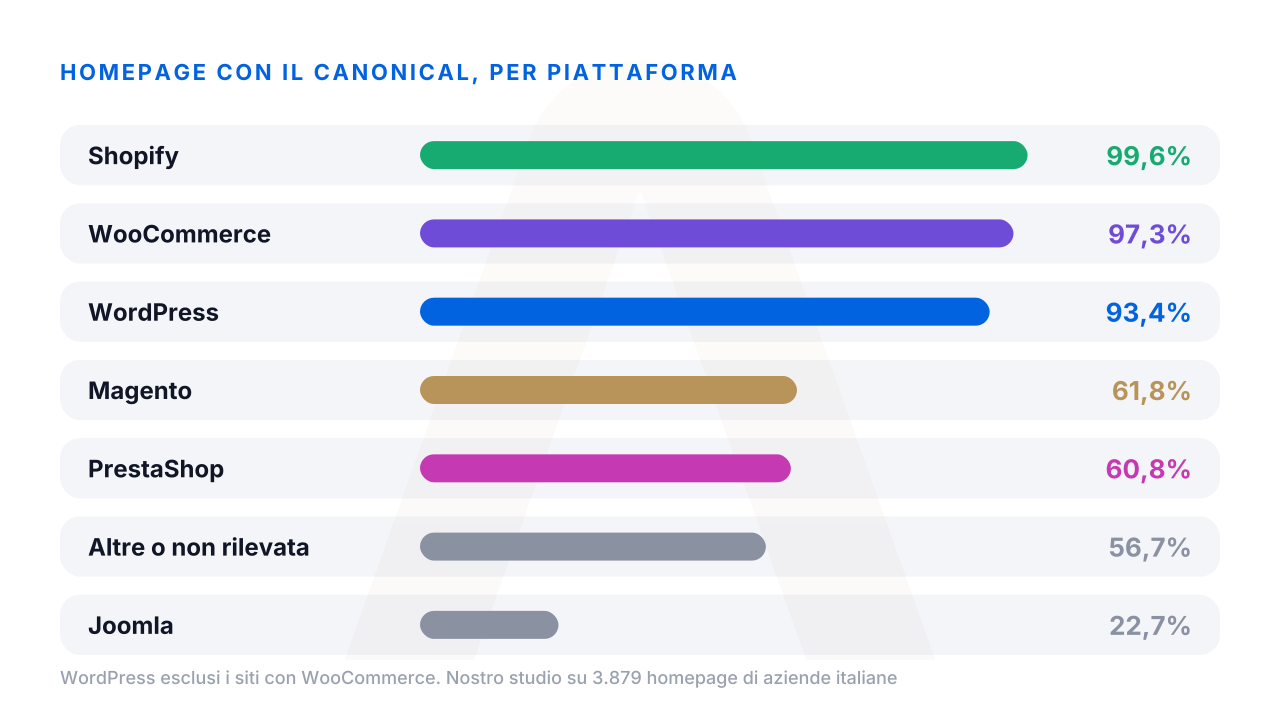
La tabella confronta le piattaforme più diffuse nel campione.
| Piattaforma | Siti | Canonical | Sitemap | Organization | llms.txt |
|---|---|---|---|---|---|
| Shopify | 463 | 99,6% | 98,9% | 82,1% | 97,8% |
| WooCommerce | 561 | 97,3% | 97,1% | 68,4% | 24,4% |
| WordPress senza WooCommerce | 716 | 93,4% | 94,1% | 62,2% | 14,9% |
| PrestaShop | 244 | 60,8% | 62,7% | 82,8% | 13,6% |
| Magento | 147 | 61,8% | 78,2% | 53,1% | 9,5% |
| Joomla | 66 | 22,7% | 36,4% | 28,8% | 4,7% |
| Altre o non rilevata | 1.449 | 56,7% | 67,2% | 33,7% | 9,1% |
Shopify arriva già configurato su quasi tutto, mentre PrestaShop e Magento hanno il canonical in sei siti su dieci. Per chi usa queste piattaforme, una SEO Shopify o una SEO Prestashop partono quindi da basi molto diverse.
Nel gruppo «Altre o non rilevata», che riunisce le piattaforme poco diffuse e i siti senza una piattaforma riconoscibile, il canonical manca in oltre quattro casi su dieci e il 15,5% risponde su due versioni del dominio. La scelta del sistema pesa già in fase di progetto, come mostra anche il confronto tra le piattaforme e-commerce più usate in Italia per costi e funzioni.
Quali controlli di SEO tecnica fare sul proprio sito?
I controlli da fare sulla homepage sono sei, dal problema più diffuso al meno diffuso:
- Un H1 chiaro, che descriva l'azienda e la sua attività.
- Una meta description breve che riassuma l'offerta, per non lasciare lo snippet al caso.
- Un tag canonical che punti all'indirizzo principale della pagina, con protocollo e www coerenti.
- Un redirect 301 verso la versione principale del dominio, dalla variante con o senza www e dalla versione HTTP.
- Una riga
Sitemap:nel robots.txt, con l'indirizzo completo della sitemap XML. - Una scelta sui crawler AI: verificare cosa contiene il robots.txt, in particolare se il sito usa Cloudflare, e decidere quali bloccare.
Questi controlli sono il primo passo di un audit SEO tecnico, che guarda anche le pagine interne. Lo studio si ferma alle homepage, ma molti problemi stanno nelle schede prodotto, nelle categorie e negli articoli.
Conclusioni
Le basi della SEO tecnica dipendono molto dalla piattaforma: chi usa Shopify, WooCommerce o WordPress le trova in gran parte già impostate, chi ha un sito su misura o una piattaforma poco diffusa deve verificarle una per una. L'elemento che manca più spesso è anche il più semplice da correggere: il titolo principale della homepage.
Sui crawler AI la maggior parte delle aziende non ha ancora preso una decisione: l'86,8% dei robots.txt non nomina nessun crawler AI, e chi blocca lo fa per lo più contro l'addestramento dei modelli, spesso con il modello preimpostato da Cloudflare. Per un'analisi tecnica del tuo sito e delle sue pagine interne puoi contattarci.
Domande frequenti
Cos'è la SEO tecnica?
La SEO tecnica riguarda tutto ciò che permette ai motori di ricerca di trovare, scansionare e indicizzare un sito: codice, server, redirect, sitemap, robots.txt, canonical e dati strutturati. È la base su cui lavorano i contenuti e i link: una pagina che Google non riesce a leggere non si posiziona, qualunque sia il suo testo.
Come controllare la SEO di un sito?
Il controllo parte dalla scansione del sito con uno strumento di crawling e da Google Search Console, per verificare pagine indicizzate, errori e redirect. Sulla homepage puoi verificare subito title, meta description, H1, canonical e robots.txt, gli elementi che in questo studio mancano più spesso.
Come si chiama la SEO per le AI?
Si chiama GEO, Generative Engine Optimization: lavora sulla presenza di un sito nelle risposte dei sistemi di intelligenza artificiale, mentre la SEO lavora sul posizionamento nei risultati dei motori di ricerca. Le basi tecniche sono le stesse: un sito che i crawler non riescono a leggere resta fuori da entrambi.
Cos'è il file robots.txt?
Il robots.txt è un file di testo nella radice del dominio che indica ai crawler quali parti del sito possono scansionare. Lo usa il 90,1% delle aziende del campione e il 9,4% lo usa anche per bloccare almeno un crawler AI.
Cos'è un crawler?
Un crawler è un programma che visita le pagine web in modo automatico per raccoglierne i contenuti. Googlebot li raccoglie per l'indice di Google, mentre crawler come GPTBot o ClaudeBot li raccolgono anche per addestrare i modelli di intelligenza artificiale.
Cos'è la meta description?
La meta description è il breve testo che descrive la pagina e che Google può mostrare sotto il titolo nei risultati di ricerca. Manca nel 17,0% delle homepage analizzate.
Cosa sono i dati strutturati?
I dati strutturati sono informazioni scritte in un formato standard, come JSON-LD, che descrivono a Google il contenuto della pagina: un'azienda, un prodotto, un evento. Il 66,5% delle homepage del campione ne contiene almeno un blocco.
Cos'è llms.txt?
llms.txt è un file proposto nel 2024 per offrire ai modelli linguistici una guida ai contenuti principali del sito. È presente nel 23,6% delle aziende analizzate, ma nella maggior parte dei casi è generato in automatico da Shopify o da un plugin SEO.
Come inviare la sitemap a Google?
La sitemap si invia dal rapporto Sitemap di Google Search Console, indicandone l'indirizzo completo. In più è utile dichiararla nel robots.txt con una riga Sitemap:, cosa che oggi fa il 69,2% delle aziende del campione.
Fonti: rapporto completo su Zenodo, DOI 10.5281/zenodo.24112421; Chrome UX Report; documentazione di Google Search Central su snippet, canonical, sitemap e crawler; OpenAI, Overview of OpenAI Crawlers; Anthropic, ClaudeBot e crawler collegati; Cloudflare, Managed robots.txt; Casaleggio Associati, Ecommerce Tech Trends 2026 (via Byte.it).
Iscriviti alla newsletter
Ricevi la newsletter via email. Puoi disiscriverti quando vuoi.