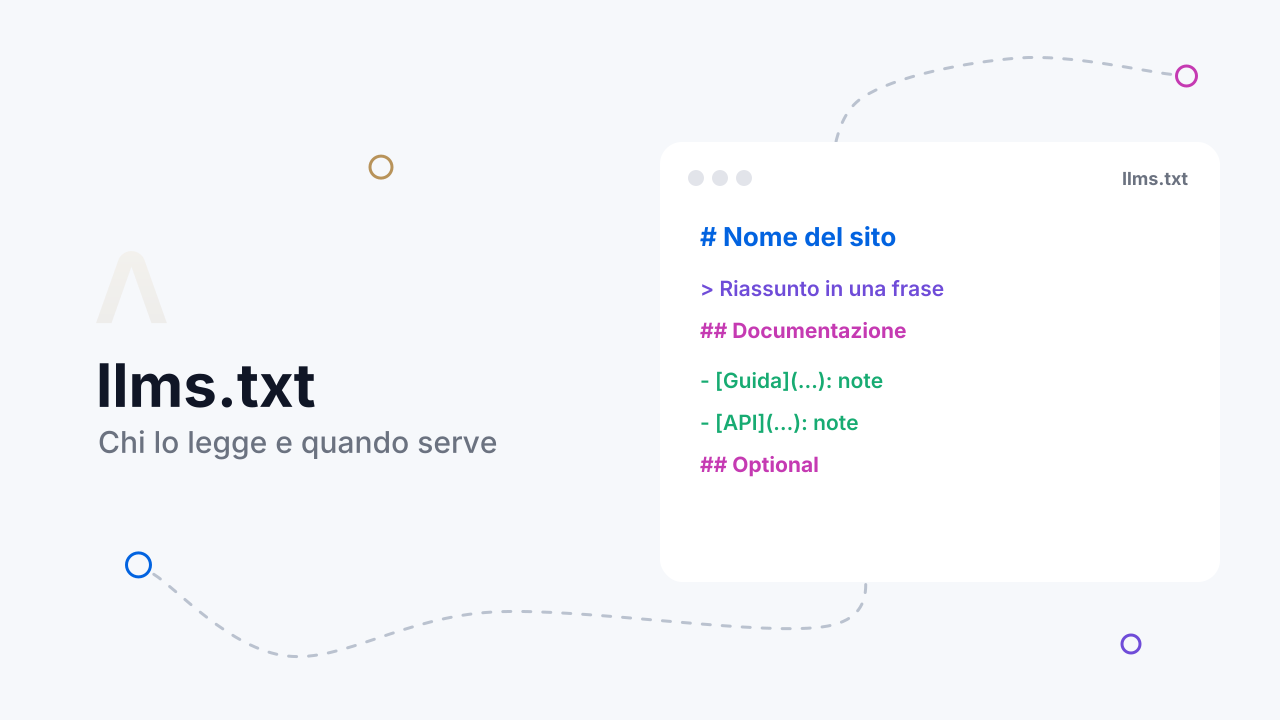
Il file llms.txt serve a farsi citare da ChatGPT e dalle altre AI? Oggi no: è un file di testo in Markdown, proposto nel 2024 da Jeremy Howard, che presenta a un agente AI una selezione dei contenuti di un sito, ma i motori generativi non dichiarano di usarlo come criterio per le fonti e la guida di Google sull’AI generativa scrive che la Ricerca lo ignora. È utile in casi precisi, soprattutto per la documentazione tecnica.
Il file llms.txt in breve
- Che cos’è: un file Markdown nella root del sito con il nome del sito, un riassunto e un elenco di link commentati.
- Stato: proposta di un privato, pubblicata su llmstxt.org il 3 settembre 2024; versione 2 del 10 agosto 2026.
- Unico elemento obbligatorio: un titolo H1 con il nome del sito o del progetto, come prima riga.
- Google: la Ricerca lo ignora; Lighthouse lo controlla in una categoria sperimentale.
- Chi lo legge: in uno studio di Ahrefs sui log di maggio 2026 di 137.210 siti, il 97% dei file non ha ricevuto alcuna richiesta.
- In Italia: a fine settembre 2026 lo pubblicavano 6 dei 16 siti SEO della nostra rilevazione, 4 in forma conforme.
- llms-full.txt: non fa parte della specifica; è una convenzione delle piattaforme di documentazione.
Cos’è il file llms.txt e a cosa serve?
È un documento in Markdown, pubblicato nella root di un sito o in una sua sottocartella, che descrive il sito e rimanda ai contenuti più utili con link commentati. L’obiettivo dichiarato dalla specifica è aiutare un modello linguistico a usare il sito al momento della risposta, con un testo abbastanza breve da stare nella sua finestra di contesto.
Il proponente scrive che il file era pensato soprattutto per l’inferenza, cioè per le risposte date in tempo reale, più che per l’addestramento dei modelli. L’uso più diffuso descritto nella specifica è la documentazione di software, letta dagli agenti di programmazione, con esempi estesi ad aziende, curriculum e scuole.
Consulenza SEO
Un consulente SEO unico dall’audit ai risultati, per più contatti e vendite dal canale organico.
La proposta di Jeremy Howard e la versione 2
La proposta è di Jeremy Howard, pubblicata su llmstxt.org il 3 settembre 2024. Non è uno standard approvato da un ente come l’IETF, a differenza del robots.txt. Il 10 agosto 2026 la specifica è passata alla versione 2, con i cambiamenti elencati nella pagina delle modifiche, che a fine settembre 2026 quasi nessuna guida italiana aveva ancora recepito:
- Sottocartelle: un file nella cartella
/docs/copre solo le pagine sotto quel percorso; vale il file più specifico. - Sezione "Optional": resta una convenzione per i link secondari, ma perde il significato operativo che aveva nella prima versione.
- Versioni Markdown delle pagine: sono ammessi sia
pagina.html.mdsiapagina.md. - Scoperta: una pagina può indicare il file che la descrive con
rel="describedby", in un tag<link>o in un’intestazione HTTP.
Come si scrive un llms.txt?
Il file segue un ordine preciso: prima un titolo H1 con il nome del sito, unico elemento obbligatorio; poi, facoltativi, un riassunto in forma di citazione, alcuni paragrafi di dettaglio senza titoli e le sezioni introdotte da un H2 con elenchi di link. Ogni voce di elenco contiene un link Markdown, seguito eventualmente da due punti e una nota. Questo è un esempio conforme scritto per un’azienda immaginaria:
# Ferramenta Rossi

> Negozio di ferramenta e utensili a Torino, con vendita online in tutta Italia. Spedizioni e resi sono spiegati nelle pagine di assistenza.

Le schede prodotto indicano disponibilità e prezzo aggiornati ogni giorno.

## Assistenza

- [Spedizioni](https://www.esempio.it/spedizioni/): tempi e costi per zona
- [Resi e rimborsi](https://www.esempio.it/resi/): condizioni e procedura

## Catalogo

- [Utensili elettrici](https://www.esempio.it/utensili-elettrici/): trapani, avvitatori, smerigliatrici

## Optional

- [Chi siamo](https://www.esempio.it/chi-siamo/): storia del negozio
La specifica consiglia un linguaggio chiaro, descrizioni brevi per ogni link e una prova pratica: chiedere a un agente di rispondere a qualche domanda partendo solo dal file. Perché un agente lo legga, il file deve rispondere con il codice 200 come testo e i link devono portare a pagine esistenti.
Gli errori nei file reali
Nei file raccolti a fine settembre 2026 su 64 siti italiani sono comparsi questi errori:
- Testo prima del titolo: due file generati da un plugin SEO aprivano con una frase di presentazione e mettevano l’H1 dopo, contro l’ordine della specifica.
- Titolo sbagliato: un H1 con l’indirizzo del sito o con un riferimento tecnico al posto del nome.
- File finto: tre siti rispondevano a quell’indirizzo con la home in HTML, così un agente riceve una pagina web al posto del Markdown.
- Uso improprio: un sito indicava il file nella riga Sitemap del robots.txt, dove i motori si aspettano una sitemap.
Cos’è llms-full.txt e perché non è nella specifica?
Il file llms-full.txt contiene il testo completo della documentazione in un solo file e non compare né nella prima né nella seconda versione della specifica. È una convenzione diffusa dalle piattaforme che ospitano documentazione tecnica, come Mintlify, e da alcuni plugin, tra cui AIOSEO.
Le dimensioni dei file reali mostrano perché si tratta di un’altra cosa. A novembre 2026 il file completo della documentazione di Anthropic pesa circa 49 MB, quello di Cloudflare circa 70 MB e quello di Vercel circa 12 MB. La specifica chiede invece un file abbastanza piccolo da stare nella finestra di contesto di un modello.
Che differenza c’è tra llms.txt, robots.txt e sitemap XML?
I tre file hanno scopi diversi e non si sostituiscono. Il robots.txt stabilisce cosa i crawler possono scansionare; la sitemap elenca le pagine per i motori di ricerca; il llms.txt presenta una selezione di contenuti con descrizioni, senza alcuna regola di accesso.
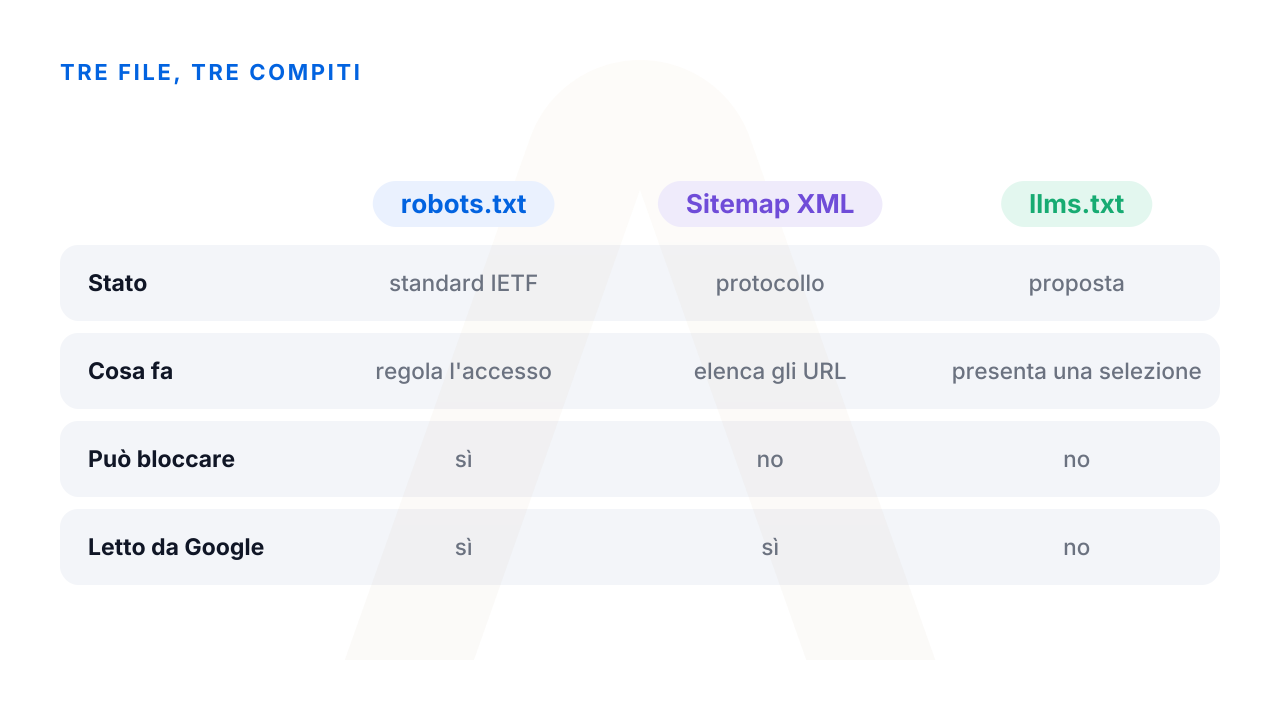
La differenza più importante riguarda il controllo. Questo file non può bloccare nulla: chi vuole escludere i propri contenuti dall’addestramento dei modelli deve usare il robots.txt con i bot dedicati, di cui si occupa la guida alla Generative Engine Optimization. A fine settembre 2026 alcune guide italiane gli attribuivano funzioni di blocco che la specifica non prevede.
Google usa llms.txt?
La Ricerca Google no. Nella sua guida sull’AI generativa Google scrive che non servono file di testo per l’AI o markup speciali per comparire nella Ricerca, comprese AI Overview e AI Mode, perché la Ricerca non li usa; secondo la stessa guida crearli non aiuta né danneggia visibilità e posizionamento.
Altri prodotti di Google trattano il file in modo diverso. Lighthouse, lo strumento di audit di Chrome, lo controlla in una categoria sperimentale chiamata Agentic Browsing, che richiede Chrome 150 o successivo: se il file manca il controllo risulta "non applicabile" e segnala un problema solo se il server risponde con un errore. La documentazione per sviluppatori delle API Gemini pubblica il proprio file: pubblicarlo, però, è diverso dal leggerlo come segnale.
ChatGPT, Claude e Perplexity leggono llms.txt?
Nessuno lo documenta. Le pagine ufficiali sui crawler di OpenAI e di Anthropic descrivono i loro bot e il robots.txt senza citare il file come input per trovare o citare le fonti.
Lo stesso vale per la pagina sui crawler di Perplexity. Le tre aziende pubblicano il file sui siti di documentazione per sviluppatori: a novembre 2026 developers.openai.com, platform.claude.com e docs.perplexity.ai rispondono con il file, che fa da indice per chi programma con le loro API.
Chi scarica il file secondo i log
Nei log il file risulta scaricato poco. Il 15 giugno 2026 Ahrefs ha pubblicato un’analisi dei log di 137.210 siti per il mese di maggio 2026. Ahrefs vende gli strumenti usati per lo studio e scrive che i siti del campione sono più tecnici della media del web, ma il metodo è dichiarato.
- Richieste: il 97% dei file non ha ricevuto alcuna richiesta nel mese.
- Bot che servono le risposte AI: OAI-SearchBot, PerplexityBot e simili valgono l’1,1% delle richieste.
- Agenti AI: la categoria degli agenti, che comprende Claude Code, vale il 10,5%; Claude-Code è il secondo user agent per richieste, dopo GPTBot.
- Ricerca attiva: nessun bot AI ha chiesto un file che non esisteva, quindi i bot non vanno a cercarlo.
Uno studio di SE Ranking su quasi 300.000 domini, nella versione del 15 ottobre 2026, ha trovato il file sul 10,13% dei siti e nessuna correlazione tra la sua presenza e le citazioni nelle risposte AI. Come riporta Search Engine Journal il 17 aprile 2025, John Mueller di Google ha paragonato il file al meta tag keywords.
Quanti siti italiani hanno un llms.txt?
Nel nostro campione il file era raro e non sempre corretto. Il 30 settembre 2026 abbiamo letto con uno script, una richiesta al secondo, l’indirizzo /llms.txt di 64 siti italiani: 16 siti di agenzie, consulenti e servizi SEO e 48 grandi siti di settori diversi. Abbiamo considerato valido un file che risponde 200 come testo e inizia con un titolo H1.
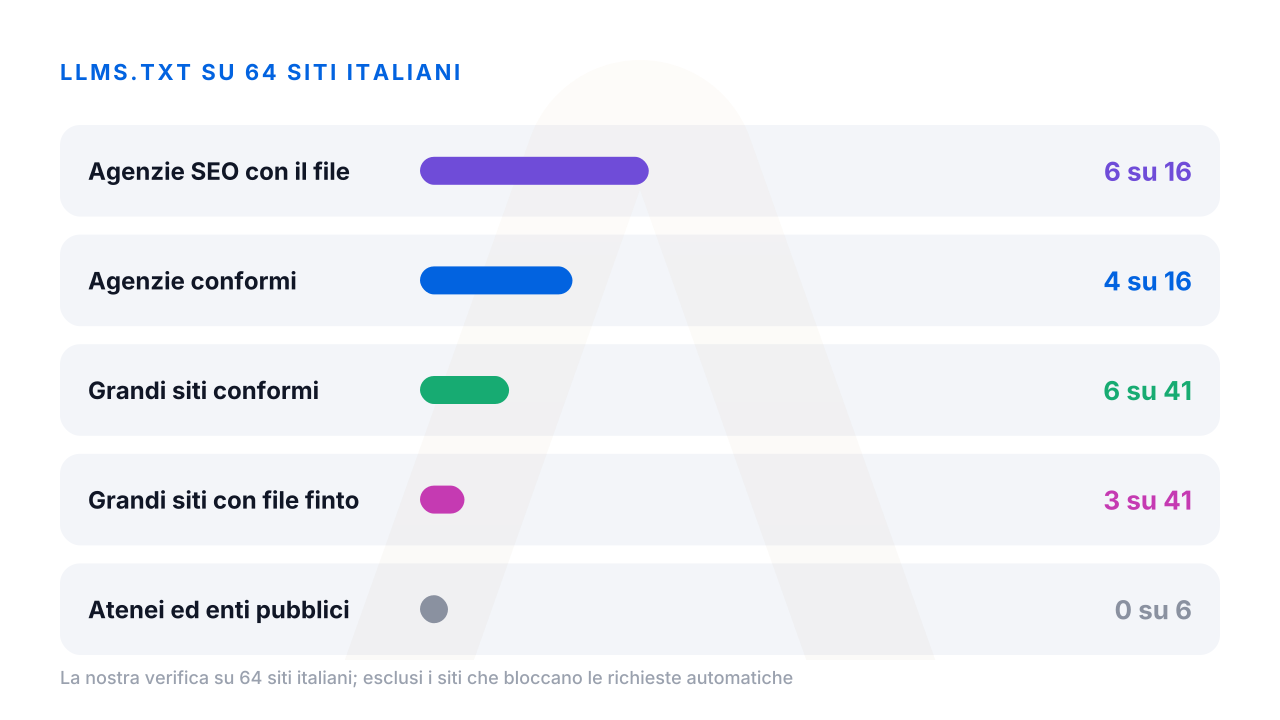
- Agenzie e consulenti SEO: 6 su 16 pubblicavano il file, 4 dei quali conformi; 1 aveva anche un llms-full.txt valido.
- Grandi siti: dei 41 con un esito leggibile, 6 avevano un file conforme, pari al 15%; 3 rispondevano con la home in HTML.
- Settori: banche e assicurazioni erano il settore con più file, 3 su 6; nessuno degli atenei e degli enti pubblici con un esito leggibile ne pubblicava uno.
- llms-full.txt: valido su 1 solo dei 48 grandi siti.
È una fotografia su un campione piccolo, senza valore di statistica nazionale: nel campione il file era più diffuso tra i siti del settore SEO, 6 su 16, che tra i grandi siti, 7 su 41 contando anche il file non conforme.
Come si crea llms.txt su WordPress, Wix e Shopify?
Su WordPress lo generano plugin SEO come Yoast SEO dalla versione 25.3 del 10 giugno 2025, AIOSEO (che crea anche il llms-full.txt) e Rank Math con un modulo dedicato.
Wix genera e aggiorna il file in automatico, con la possibilità di modificarlo o di nasconderlo; su Shopify si crea con app di terzi dello Shopify App Store.
Qualunque strumento si usi, il file va aperto e letto: nella rilevazione di settembre 2026 i due file non conformi dei siti SEO erano generati da un plugin che anteponeva una frase al titolo. Il controllo è semplice: la prima riga deve essere # Nome del sito e i link devono funzionare.
Quando conviene pubblicare un llms.txt?
Conviene a chi ha documentazione tecnica, API o prodotti che le persone usano tramite agenti di programmazione e assistenti, perché sono i lettori che compaiono nei log. Su un sito aziendale o un e-commerce è facoltativo: il file richiede poco lavoro e non crea problemi, però va considerato un servizio in più per gli agenti, senza aspettarsi effetti sulle citazioni.
Per le funzionalità di AI generativa della Ricerca, la guida di Google indica di dare la priorità alle strategie SEO efficaci e a contenuti unici, basati sull’esperienza. La guida su AI Overview tratta gli stessi temi nel dettaglio.
Se il tuo sito rientra nel primo gruppo, il file merita la stessa cura di una pagina di documentazione; se rientra nel secondo, il tempo rende di più sulle pagine che gli assistenti già leggono. Su quale delle due strade abbia senso per te puoi sentire il nostro parere: è una valutazione che rientra in una consulenza SEO orientata anche ai motori generativi.
Domande frequenti su llms.txt
llms.txt è uno standard ufficiale?
No. Jeremy Howard l’ha proposto su llmstxt.org il 3 settembre 2024 e nessun ente come IETF o W3C l’ha approvato. La versione 2 della specifica è del 10 agosto 2026.
Dove va messo il file?
Nella root del sito, all’indirizzo /llms.txt, oppure in una sottocartella come /docs/. Dalla versione 2 un file in una sottocartella copre solo le pagine sotto quel percorso e, se più file valgono per la stessa pagina, conta quello più specifico.
llms.txt aiuta la SEO su Google?
No. La Ricerca Google non usa file di testo per l’AI, quindi crearli non aiuta né danneggia visibilità e posizionamento, anche nelle AI Overview e in AI Mode. Il file può servire ad altri servizi che lo leggono.
ChatGPT, Claude e Perplexity leggono llms.txt?
Nessuno dei tre lo documenta come input per trovare o citare le fonti. Nei log di maggio 2026 di oltre 137.000 siti, i bot che servono le risposte AI valevano l’1,1% delle richieste al file.
Che differenza c’è tra llms.txt e robots.txt?
Il robots.txt stabilisce cosa i crawler possono scansionare ed è uno standard IETF. Il file per gli agenti AI presenta una selezione di contenuti con descrizioni e non contiene regole: non può bloccare nulla.
Cos’è llms-full.txt?
Un file con il testo completo della documentazione, diffuso da piattaforme come Mintlify e da alcuni plugin. Non fa parte della specifica e i file reali possono pesare decine di megabyte.
Come si crea il file su WordPress?
Con plugin SEO come Yoast SEO dalla versione 25.3, AIOSEO o Rank Math, oppure scrivendolo a mano. In ogni caso il file va aperto, per vedere che la prima riga sia il titolo con il nome del sito.
Come si controlla se il file è valido?
Deve rispondere con il codice 200 come testo, senza reindirizzare alla home, iniziare con un titolo H1 con il nome del sito e contenere link che portano a pagine esistenti.
Iscriviti alla newsletter
Ricevi la newsletter via email. Puoi disiscriverti quando vuoi.