Un file di poche righe può fermare la scansione di un intero sito? Sì: il robots.txt è il file di testo, nella root di ogni host, che dice ai crawler quali URL possono visitare; un errore di sintassi o una risposta sbagliata del server bastano a bloccare Google. Il file regola la scansione; l’indicizzazione dipende da altro, tanto che una pagina bloccata può comunque comparire nei risultati.
Il robots.txt in breve
- Cos’è: un file di testo UTF-8 nella root dell’host che indica ai crawler i percorsi da non scansionare.
- Standard: RFC 9309, pubblicata dall’IETF a settembre 2022.
- Regole lette da Google: user-agent, allow, disallow e sitemap; crawl-delay e noindex vengono ignorati.
- Precedenza: conta il gruppo più specifico per il crawler e, dentro il gruppo, la regola più lunga; a parità vince la meno restrittiva.
- Limiti: Google legge al massimo 500 KiB e tiene il file in cache fino a 24 ore.
- Se il file dà errore 5xx: Google ferma la scansione del sito per 12 ore, poi usa l’ultima copia valida fino a 30 giorni.
- Cosa non fa: non toglie una pagina da Google e non protegge contenuti riservati.
Cos’è il file robots.txt e a cosa serve?
Si tratta dell’applicazione del Robots Exclusion Protocol, il protocollo con cui un sito indica ai crawler quali percorsi non devono visitare. Martijn Koster lo ha definito nel 1994; a settembre 2022 è diventato uno standard IETF con la RFC 9309, firmata da Koster e da tre ingegneri di Google.
La guida di Google scrive che serve soprattutto a gestire il traffico dei crawler per non sovraccaricare il server (il tema del crawl budget sui siti grandi) e che non è un meccanismo per tenere una pagina fuori dai risultati. La stessa RFC precisa che le regole non sono una forma di autorizzazione all’accesso: i crawler dei motori di ricerca le rispettano, ma un bot qualsiasi può ignorarle.
Audit SEO
Audit SEO tecnico per siti ed e-commerce, con gli interventi ordinati per impatto.
Dove si trova e a quali indirizzi si applica?
Il file si trova sempre nella root dell’host, all’indirizzo https://www.esempio.it/robots.txt; vale solo per il protocollo, l’host e la porta da cui viene servito. Un file messo in una sottocartella viene ignorato; anche il nome è sensibile alle maiuscole.
- Protocollo: il file di
https://esempio.itnon vale perhttp://esempio.it. - Sottodominio: il file di
www.esempio.itnon vale peresempio.itné pershop.esempio.it. - Porta: una porta non standard, come 8181, ha bisogno di un file proprio.
Nei siti con un negozio o un blog su un sottodominio, ogni host ha quindi il suo file da mantenere. Il report di Search Console dedicato al file, su una proprietà di tipo Dominio, mostra i file trovati per i primi 20 host.
Come si scrive un robots.txt?
Il file è fatto di gruppi: ogni gruppo inizia con una o più righe user-agent, che indicano a quali crawler si rivolge, seguite dalle regole disallow e allow. La riga sitemap sta fuori dai gruppi e contiene l’URL completo della sitemap. Questo è l’esempio della guida di Google:
User-agent: Googlebot
Disallow: /nogooglebot/

User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
Le regole di sintassi da conoscere sono poche:
- Percorsi: partono da
/e sono sensibili alle maiuscole;Disallow: /Admin/non blocca/admin/. - Cartelle: vanno chiuse con la barra;
/fishblocca anche/fishheadse/fish.html, mentre/fish/blocca solo il contenuto della cartella. - Caratteri speciali:
*sta per qualsiasi sequenza di caratteri,$indica la fine dell’URL;Disallow: /*.pdf$blocca i PDF ma non/file.pdf?v=2, perché il parametro allunga l’URL. - Formato: testo UTF-8 scritto con un editor di testo semplice; un word processor inserisce virgolette curve e formattazioni che rendono invalide le righe.
- Dimensione: Google legge i primi 500 KiB e ignora il resto.
La riga sitemap deve contenere l’URL completo di una sitemap, come indica la specifica di Google, e non l’indirizzo della home del sito. Nei risultati di Google Italia che abbiamo rilevato a settembre 2026, l’AI Overview per "robots txt esempio" proponeva una riga Sitemap: che puntava alla home del sito: un errore da non copiare.
Quali regole supporta Google e quali ignora?
Google legge quattro campi: user-agent, allow, disallow e sitemap. Tutto il resto viene ignorato: la sua documentazione cita esplicitamente crawl-delay tra i campi non supportati.
- Noindex: dal 1° settembre 2019 Google non lo legge più in questo file; per escludere una pagina dall’indice serve il meta tag robots, con la pagina lasciata scansionabile.
- Crawl-delay: Google non lo ha mai documentato né supportato e gestisce la frequenza da sé. Bing lo supporta e, come spiega in un post sul suo crawler, lo interpreta come la durata di una finestra temporale in cui scansiona al massimo una pagina, senza fissare una pausa tra le richieste.
- Clean-param: supportato da alcuni motori; Google lo ignora.
A settembre 2026 diverse guide italiane in prima pagina presentavano ancora il crawl-delay come direttiva valida; una scriveva che Googlebot lo usava in passato. Nel post del 2 luglio 2019 Google scrive il contrario: crawl-delay, nofollow e noindex come regole del file non sono mai stati documentati, e dal 1° settembre 2019 smette di gestirli.
Quale regola vince quando due regole sono in conflitto?
Secondo la sua specifica, Google applica due criteri in sequenza: prima sceglie il gruppo, poi la regola. Per il gruppo vale quello con lo user-agent più specifico per il crawler, a prescindere dall’ordine nel file; per la regola vale quella con il percorso più lungo o, a parità di lunghezza, la meno restrittiva.
Il primo criterio nasconde un errore insidioso. Un gruppo dedicato a Googlebot non si somma al gruppo *: lo sostituisce. Se aggiungi User-agent: Googlebot con una sola regola, Googlebot smette di rispettare tutti i Disallow scritti per *, che vanno quindi ripetuti nel gruppo specifico. Bing segue lo stesso principio, con un’eccezione per il crawl-delay; il crawler di Brave Search non usa uno user agent distinto e non scansiona ciò che è bloccato per Googlebot.
Per il secondo criterio, questi sono alcuni dei casi documentati da Google:
- URL
/pageconallow: /pedisallow: /: vince allow, perché il percorso è più lungo. - URL
/folder/pageconallow: /folderedisallow: /folder: vince allow, perché a parità conta la regola meno restrittiva. - URL
/page.htmconallow: /pageedisallow: /*.htm: vince disallow, perché ha più caratteri. - URL
/conallow: /$edisallow: /: vince allow, che vale solo per la home.
Tutti gli strumenti leggono il file allo stesso modo?
No: lo abbiamo verificato a novembre 2026 passando lo stesso file al modulo urllib.robotparser della libreria standard di Python 3.9.6. Con Disallow: / seguito da Allow: /public/, il parser ha bloccato /public/pagina, che per Google e per la RFC 9309 è consentita; con Disallow: /*.pdf$ ha lasciato passare /doc.pdf, perché non interpreta * e $ come lo standard.
La conseguenza pratica: un tester o un generatore online non basato sulla libreria open source di Google può dare risposte diverse da quelle di Googlebot. Scrivere le regole allow prima delle disallow dello stesso gruppo rende il file leggibile allo stesso modo anche dai parser che applicano la prima regola trovata.
Quando il file risponde con un errore
La risposta HTTP del file conta quanto il suo contenuto. Secondo la specifica di Google, un file che dà 404 vale come assente, quindi senza restrizioni; un errore del server invece ferma la scansione, ed è il caso più grave e il meno raccontato dalle guide italiane che abbiamo letto a settembre 2026.
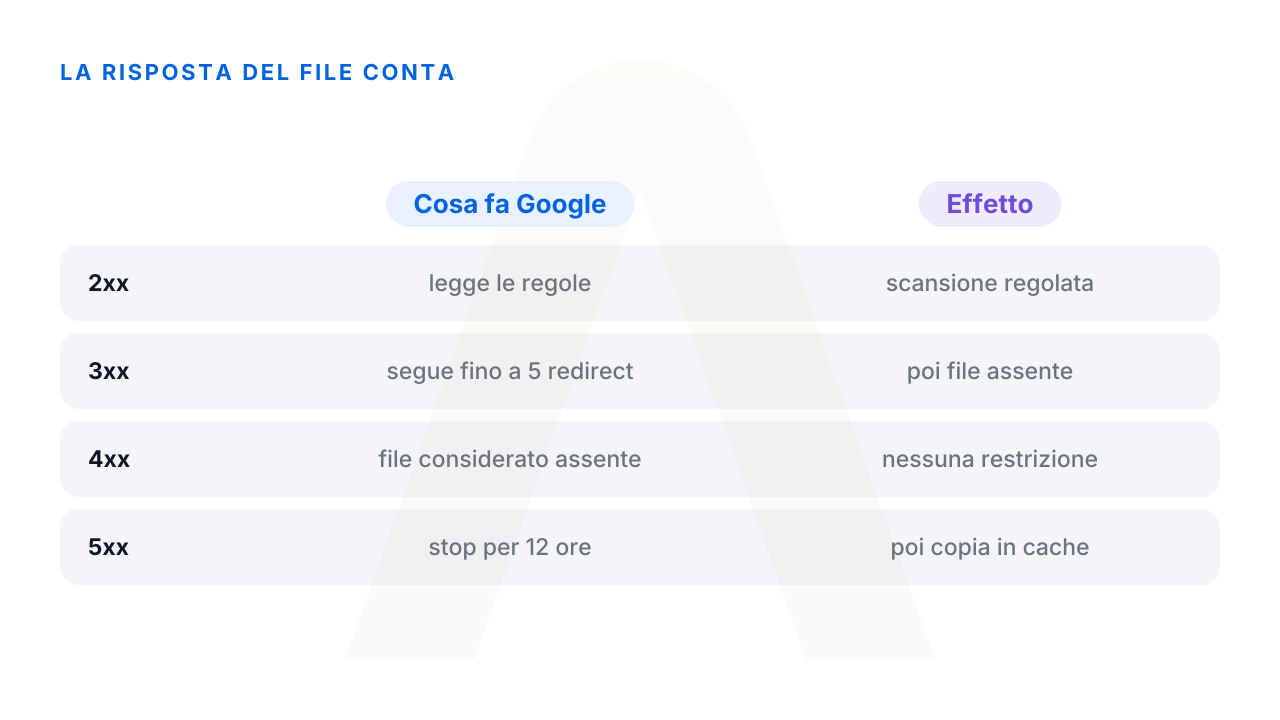
- 2xx: Google elabora il file.
- 3xx: segue almeno 5 reindirizzamenti, poi tratta il file come assente; ignora i redirect via JavaScript o meta refresh.
- 4xx, tranne 429: nessuna restrizione; 401 e 403 non servono a rallentare la scansione.
- 5xx, timeout o errori DNS: per le prime 12 ore la scansione del sito si ferma; poi, per 30 giorni, Google usa l’ultima versione valida in cache; senza una copia in cache scansiona senza restrizioni.
Uno scenario possibile: un firewall o un sistema anti-bot configurato dopo un rilascio blocca le richieste di Googlebot al file con un errore 5xx: per 12 ore Google non scansiona nessuna pagina del sito. Nel report Statistiche di scansione di Search Console lo stato dell’host segnala proprio i problemi di recupero del file.
Il file su WordPress e Shopify
In WordPress e Shopify il file è generato dalla piattaforma. WordPress lo genera al volo, senza un file fisico sul server, che blocca l’area di amministrazione lasciando accessibile il file usato dalle richieste AJAX e, dalla versione 5.5, aggiunge la riga della sitemap:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://www.esempio.it/wp-sitemap.xml
Dalla versione 5.3 l’opzione "Scoraggia i motori di ricerca" non scrive più Disallow: / nel file ma usa il meta robots. Lo si modifica con un plugin SEO, con il filtro robots_txt o caricando un file fisico nella root. Nella SEO per WordPress è una delle prime verifiche, insieme all’opzione che scoraggia i motori di ricerca.
Shopify genera un file predefinito che, secondo la sua documentazione, va bene per la maggior parte dei negozi. Per personalizzarlo si aggiunge il template robots.txt.liquid al tema; Shopify raccomanda di usare gli oggetti Liquid invece di riscrivere il file con regole in testo semplice.
Le regole su filtri della navigazione a faccette e ricerca interna, nella SEO per Shopify, si decidono in base al catalogo, perché il file predefinito non conosce le collezioni del negozio.
Quali errori nel file bloccano un sito?
Gli errori più gravi sono quelli che bloccano più di quanto si voleva o che impediscono a Google di leggere istruzioni importanti. Questi sono documentati nelle fonti ufficiali:
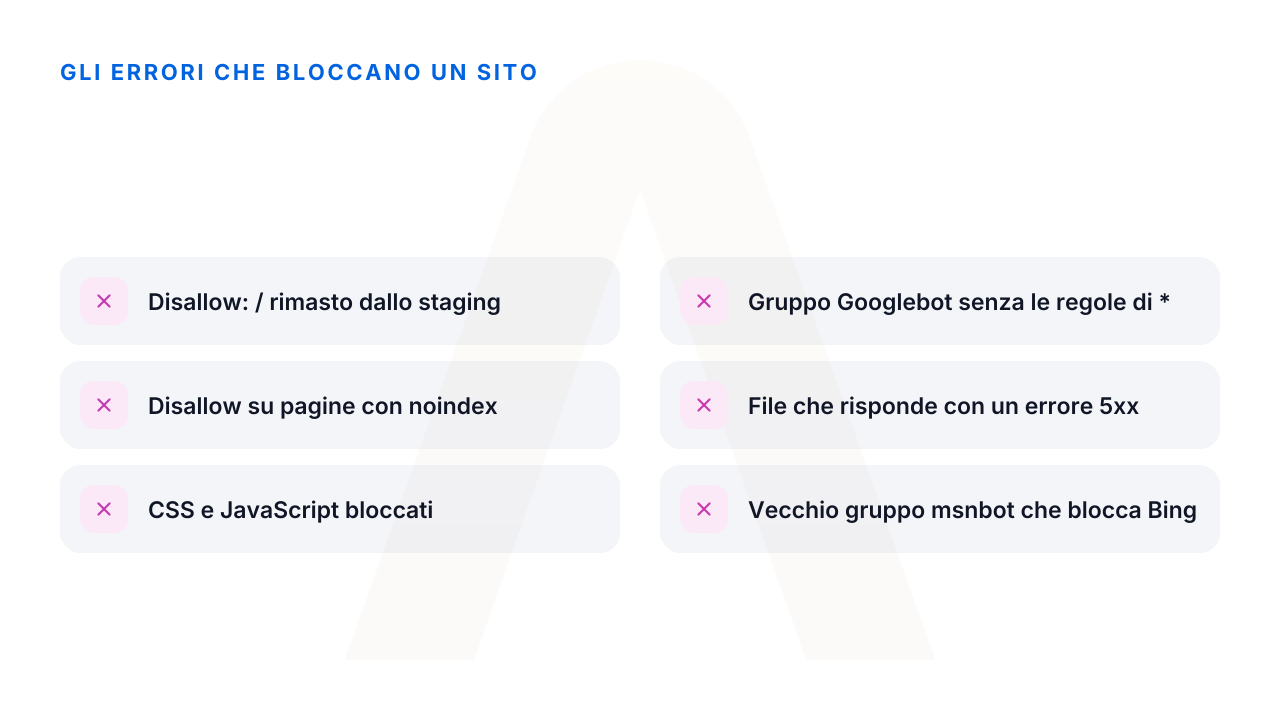
Disallow: /rimasto dallo staging: il file dell’ambiente di prova passa in produzione al termine di una migrazione del sito web o di un rilascio e blocca l’intero sito. Per proteggere lo staging serve un’autenticazione: la RFC 9309 ricorda che elencare un percorso nel file lo rende pubblico.- Disallow su una pagina con noindex: Google non può scansionare la pagina e quindi non vede il noindex.
- CSS e JavaScript bloccati: se senza queste risorse Google fatica a capire la pagina, la sua guida chiede di non bloccarle.
- Gruppo Googlebot senza le regole generali: Googlebot ignora il gruppo
*e scansiona percorsi che si credevano bloccati. - File in errore 5xx: ferma la scansione di tutto il sito.
- Vecchio gruppo per msnbot: Bing ha documentato che un
User-agent: msnbotconDisallow: /vale anche per BingBot.
Anche i bot dei motori generativi, come OAI-SearchBot e GPTBot, leggono lo stesso file, con regole diverse a seconda che servano alla ricerca o all’addestramento; il file llms.txt invece non contiene regole di accesso e non può bloccarli. La guida alla Generative Engine Optimization elenca i bot di ogni motore e l’effetto di un blocco sulla visibilità.
Il robots.txt toglie una pagina da Google?
No. Impedisce la scansione, ma se altre pagine linkano l’URL bloccato Google può indicizzarlo lo stesso, mostrandolo senza descrizione. Search Console lo segnala con lo stato "Indicizzata ma bloccata da robots.txt", descritto, con gli altri stati del report, nella guida alle pagine non indicizzate.
Per togliere una pagina dai risultati serve il noindex, con la pagina lasciata scansionabile perché Google lo legga; per contenuti che non devono essere visti da nessuno serve una password.
Come si controlla il file dopo averlo modificato?
Il controllo più rapido è aprire l’indirizzo del file in una finestra privata del browser. Poi conviene usare gli strumenti di Google, perché leggono il file come Googlebot.
- Report di Search Console dedicato al file: mostra i file trovati, l’ultima scansione e gli eventuali avvisi o errori.
- Richiesta di nuova scansione: dallo stesso report, per aggiornare subito la copia in cache invece di aspettare fino a 24 ore.
- Controllo URL: verifica se un URL specifico è bloccato.
- Libreria open source di Google: per chi non ha accesso a Search Console, o per testare molti URL.
La documentazione di Google sul file si trova oggi nella sezione dedicata all’infrastruttura di scansione, insieme alla specifica.
Un file per host, da rileggere a ogni rilascio
Ogni host del sito, sottodomini compresi, ha il suo file; ogni rilascio può cambiarlo senza che nessuno se ne accorga: un file di staging copiato in produzione, un firewall che risponde 5xx a Googlebot, un gruppo specifico che dimentica le regole generali. Dopo ogni modifica conviene quindi controllare che il file risponda con 200, che la riga sitemap punti a un file valido e che il report Statistiche di scansione non segnali problemi di recupero negli ultimi 90 giorni.
Proprio perché poche righe possono fermare la scansione dell’intero sito, il file è uno dei primi punti verificati in un audit SEO. Un dubbio su una regola, o su come il server risponde ai crawler, si può discutere con noi prima del prossimo rilascio.
Domande frequenti sul robots.txt
Cos’è il file robots.txt?
È un file di testo UTF-8 nella root di ogni host che indica ai crawler quali percorsi del sito possono scansionare. Serve a gestire il traffico dei bot; per nascondere le pagine dai risultati servono altri strumenti.
Dove si trova il file dei crawler di un sito?
Sempre nella root dell’host, per esempio https://www.esempio.it/robots.txt. Vale solo per quel protocollo, quell’host e quella porta: ogni sottodominio ha il proprio. Un file messo in una sottocartella viene ignorato e il nome è sensibile alle maiuscole.
È obbligatorio avere questo file?
No. Senza file, o con un file che risponde 404, Google scansiona il sito senza restrizioni. Il file serve quando ci sono percorsi da escludere dalla scansione o per indicare la sitemap.
Cosa bisogna scrivere nel file?
Uno o più gruppi con la riga user-agent seguita dalle regole disallow e allow, più la riga sitemap con l’URL completo della sitemap. Google ignora gli altri campi, come crawl-delay e noindex.
Bloccare una pagina impedisce l’indicizzazione?
No. Blocca la scansione, ma un URL bloccato può comparire nei risultati senza descrizione se altre pagine lo linkano. Per escludere una pagina serve il noindex, con la pagina lasciata scansionabile.
Google rispetta il crawl-delay?
No, Google non supporta questo campo e regola da sé la frequenza di scansione. Bing lo supporta, interpretandolo come una finestra temporale in cui scansiona al massimo una pagina; il valore non indica una pausa tra le richieste.
Come si modifica il file su WordPress?
WordPress genera un file virtuale che blocca /wp-admin/ e, dalla versione 5.5, indica la sitemap. Si modifica con un plugin SEO, con il filtro robots_txt o caricando un file fisico nella root del sito.
Dopo quanto tempo Google legge le modifiche?
Google tiene il file in cache in genere fino a 24 ore. Per aggiornarlo prima si usa la richiesta di nuova scansione nel report di Search Console dedicato al file.
Iscriviti alla newsletter
Ricevi la newsletter via email. Puoi disiscriverti quando vuoi.