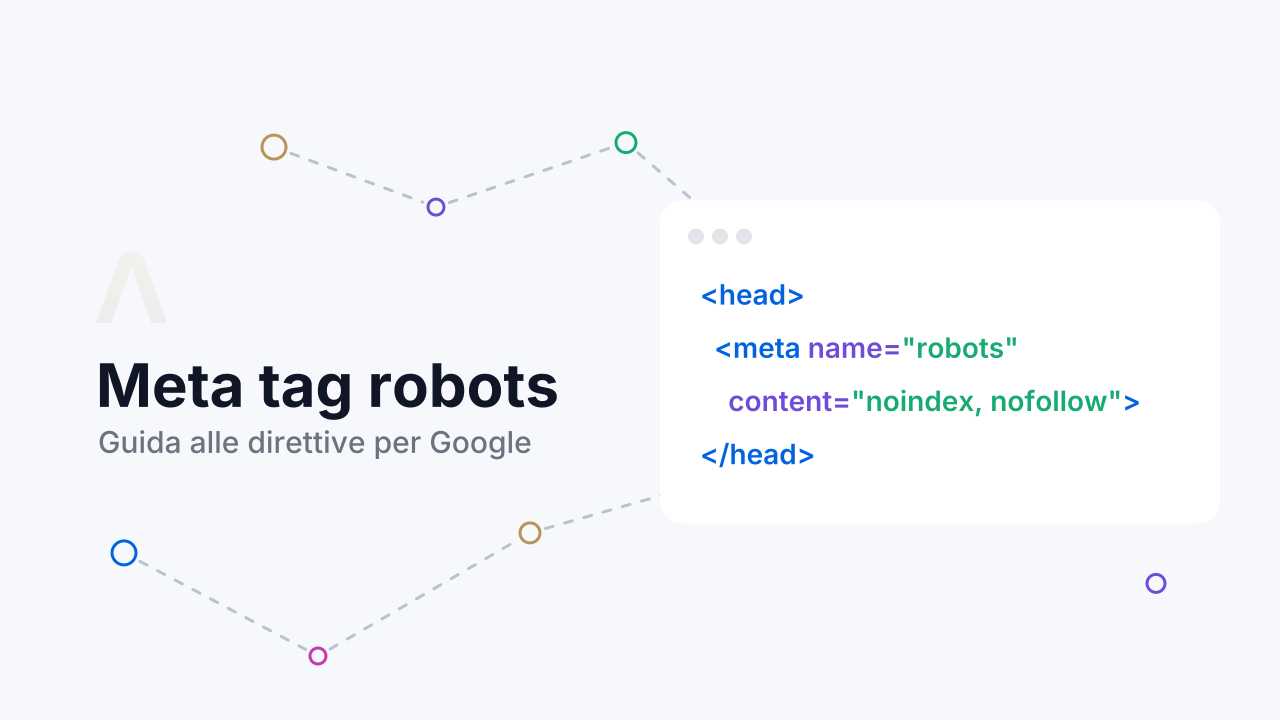
Vuoi che una pagina del tuo sito non compaia su Google, o che nei risultati non ne venga mostrata l’anteprima? Il meta tag robots serve a questo. È un tag HTML che inserisci nel <head> della pagina per dire ai motori di ricerca se possono indicizzarla, se devono seguirne i link e come possono mostrarla nei risultati.
Il meta tag robots in breve
- Cos’è: un tag HTML nel
<head>che dà ai crawler istruzioni sull’indicizzazione e sulla visualizzazione di una singola pagina. - Sintassi:
<meta name="robots" content="noindex, nofollow">; più regole si separano con una virgola. - Regole principali: noindex, nofollow, none, nosnippet, max-snippet, max-image-preview, noimageindex e unavailable_after.
- Senza tag: la pagina è indicizzabile e i link si possono seguire; non serve scrivere "index, follow".
- Differenza con il robots.txt: il robots.txt regola la scansione, il meta tag l’indicizzazione e lo snippet.
- File non HTML: per PDF e immagini si usa l’intestazione HTTP X-Robots-Tag, con gli stessi valori.
- Non più usate da Google: noarchive, nositelinkssearchbox, noodp e il noindex nel robots.txt.
Cos’è il Meta Tag Robots?
Si tratta di un tag HTML, inserito nel <head> di una pagina, che indica ai crawler dei motori di ricerca se indicizzare quella pagina, se seguirne i link e come mostrarla nei risultati. Google lo descrive nella sua documentazione come un controllo a livello di singola pagina: le sue istruzioni valgono solo per la pagina in cui si trova.
Lavora insieme al file robots.txt e all’intestazione HTTP X-Robots-Tag, gli altri strumenti con cui i siti danno istruzioni ai crawler. Questi tag esistono dal 1996; nel tempo i motori di ricerca hanno aggiunto nuove regole e ne hanno ritirate altre, per questo alcune guide in circolazione citano direttive che non hanno più effetto.
Audit SEO
Audit SEO tecnico per siti ed e-commerce, con gli interventi ordinati per impatto.
Come si Scrive il Tag Robots?
Il tag va nella sezione <head> della pagina e ha due attributi: name indica a quali crawler si rivolge; content contiene una o più regole separate da virgole. Maiuscole e minuscole non contano.
<head>
  <meta name="robots" content="noindex, nofollow">
</head>
Con name="robots" l’istruzione vale per tutti i motori di ricerca. Per rivolgerti a un crawler specifico usi il suo nome:
googlebot: solo Google, per i risultati di ricerca testuali;googlebot-news: Google News;bingbot: Bing.
Puoi usare più tag nella stessa pagina, uno per crawler. In questo caso Google applica la somma delle regole negative: con un tag googlebot che contiene nosnippet e un tag robots che contiene nofollow, per Google valgono entrambe le regole.
Cosa Succede se Due Regole Sono in Conflitto?
Se due regole si contraddicono, vince la più restrittiva. Con nosnippet e max-snippet:50 nella stessa pagina, per esempio, Google non mostra alcuno snippet.
Quali Direttive Robots Supporta Google?
Google supporta dodici regole, elencate nelle sue specifiche sul tag robots: all, noindex, nofollow, none, nosnippet, indexifembedded, max-snippet, max-image-preview, max-video-preview, notranslate, noimageindex e unavailable_after. Ecco cosa fa ciascuna:
- all: nessuna restrizione; è il valore predefinito, quindi non serve scriverlo.
- noindex: la pagina non compare nei risultati di ricerca.
- nofollow: Google non segue i link presenti nella pagina.
- none: equivale a
noindex, nofollow. - nosnippet: nei risultati non compaiono né lo snippet di testo né l’anteprima video.
- max-snippet:[numero]: limita lo snippet a un numero massimo di caratteri; 0 equivale a nosnippet, -1 toglie il limite.
- max-image-preview:[impostazione]: dimensione massima dell’anteprima delle immagini, con i valori none, standard e large.
- max-video-preview:[numero]: durata massima in secondi dell’anteprima dei video.
- notranslate: Google non propone la traduzione della pagina nei risultati.
- noimageindex: le immagini della pagina non vengono indicizzate.
- indexifembedded: insieme a noindex, consente l’indicizzazione dei contenuti quando sono incorporati in un’altra pagina tramite iframe.
- unavailable_after:[data]: la pagina esce dai risultati dopo la data indicata, in formati come ISO 8601.
Noindex: Cos’è e Quando Usarlo?
Il noindex chiede ai motori di ricerca di non mostrare la pagina nei risultati. Serve per le pagine utili a chi è già sul sito ma senza valore in una ricerca:
- le pagine di ringraziamento che una landing page o un checkout mostrano dopo l’invio di un modulo o un acquisto;
- l’area riservata e le pagine di accesso;
- i risultati della ricerca interna del sito;
- le pagine di test e le bozze pubblicate per errore.
Il noindex non è lo strumento giusto per i contenuti duplicati: per indicare a Google quale versione considerare principale si usa il tag canonical (rel="canonical"), come raccomanda la sua documentazione sui duplicati.
Che Differenza c’è tra Nofollow e rel="nofollow"?
Il nofollow del meta tag vale per tutti i link della pagina. L’attributo rel="nofollow" si applica invece al singolo link: dal 1° marzo 2020 Google lo tratta come un suggerimento e gli affianca rel="sponsored" per i link a pagamento e rel="ugc" per i contenuti generati dagli utenti.
Noindex, Nofollow e None: Cosa Cambia?
noindex, nofollow chiede di non mostrare la pagina e di non seguirne i link; none dice la stessa cosa con una sola parola. La combinazione è tipica delle pagine che non devono comparire e i cui link non servono a scoprire altre pagine, come un’area riservata.
Come Controllare lo Snippet e l’Uso nelle AI Overview?
Le regole sullo snippet decidono quanto della pagina Google può mostrare nel testo sotto il titolo, preso dalla meta description o dalla pagina: nosnippet lo elimina, max-snippet ne limita i caratteri, max-image-preview e max-video-preview regolano le anteprime. Una sola parte del testo si nasconde con l’attributo data-nosnippet, da applicare agli elementi span, div e section.
Le stesse regole valgono per le funzioni di intelligenza artificiale della Ricerca: secondo Google, nosnippet impedisce che i contenuti vengano usati come input diretto per le AI Overview e la Modalità AI, mentre max-snippet ne limita la quantità. Prima di applicarle, valuta il rovescio della medaglia: una pagina che non può essere citata può perdere anche visibilità. Per le immagini, oltre a noimageindex e max-image-preview, contano formato e testo alternativo, trattati nella guida alla SEO per le immagini insieme agli altri fattori.
Le Direttive Robots che Google Non Usa Più
Alcune regole che puoi trovare ancora nelle guide non hanno più effetto su Google:
- noindex nel robots.txt: non è supportato dal 1° settembre 2019; il noindex va nel meta tag o nell’intestazione HTTP.
- noarchive: serviva a non mostrare la copia cache, che Google ha ritirato a febbraio 2024; dal 2 ottobre 2024 la documentazione la tratta come regola storica, come riporta il registro delle modifiche di Google.
- nositelinkssearchbox: disattivava la casella di ricerca nei sitelink, rimossa dai risultati dal 21 novembre 2024.
- noodp: escludeva le descrizioni della directory DMOZ, che non esiste più.
Non è necessario togliere queste regole dalle pagine che le contengono: Google le ignora. Bing, invece, tiene ancora conto di noarchive e nocache, anche sull’uso dei contenuti nelle risposte generate con l’intelligenza artificiale.
Che Differenza c’è tra Meta Tag Robots e robots.txt?
Il robots.txt decide quali URL i crawler possono scansionare; il meta tag decide se una pagina scansionata può finire nei risultati e come. Sono due strumenti diversi e lavorano in momenti diversi.
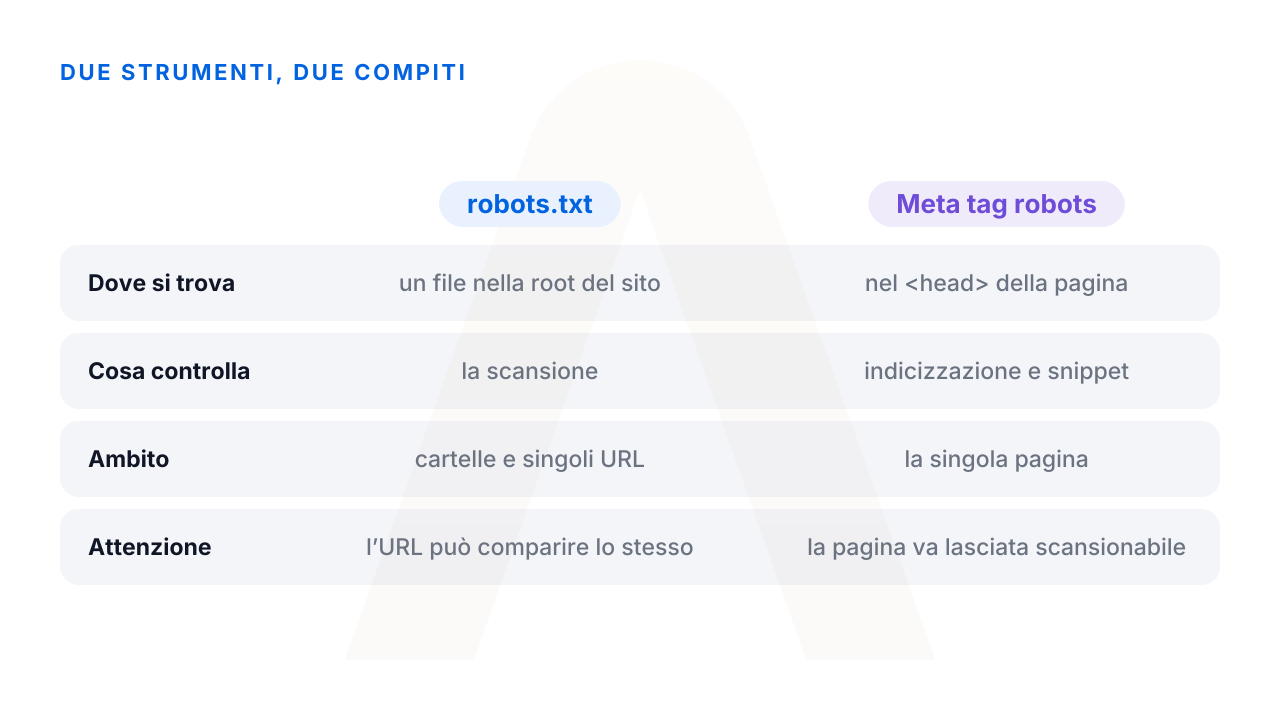
Il robots.txt non serve a tenere una pagina fuori da Google: un URL bloccato può comparire comunque nei risultati, senza descrizione, se altri siti lo linkano. Per escludere una pagina dall’indice lo strumento giusto è il noindex nel meta tag, o l’X-Robots-Tag per i file non HTML.
Cosa Succede se robots.txt e Meta Robots Sono in Conflitto?
È un errore da evitare: aggiungere il noindex a una pagina e insieme bloccarla nel robots.txt. Se l’URL è bloccato, Google non scansiona la pagina, quindi non legge il noindex; la pagina può così restare nei risultati se altre pagine la linkano, come spiega la guida di Google al noindex. La sequenza corretta per togliere una pagina da Google è questa:
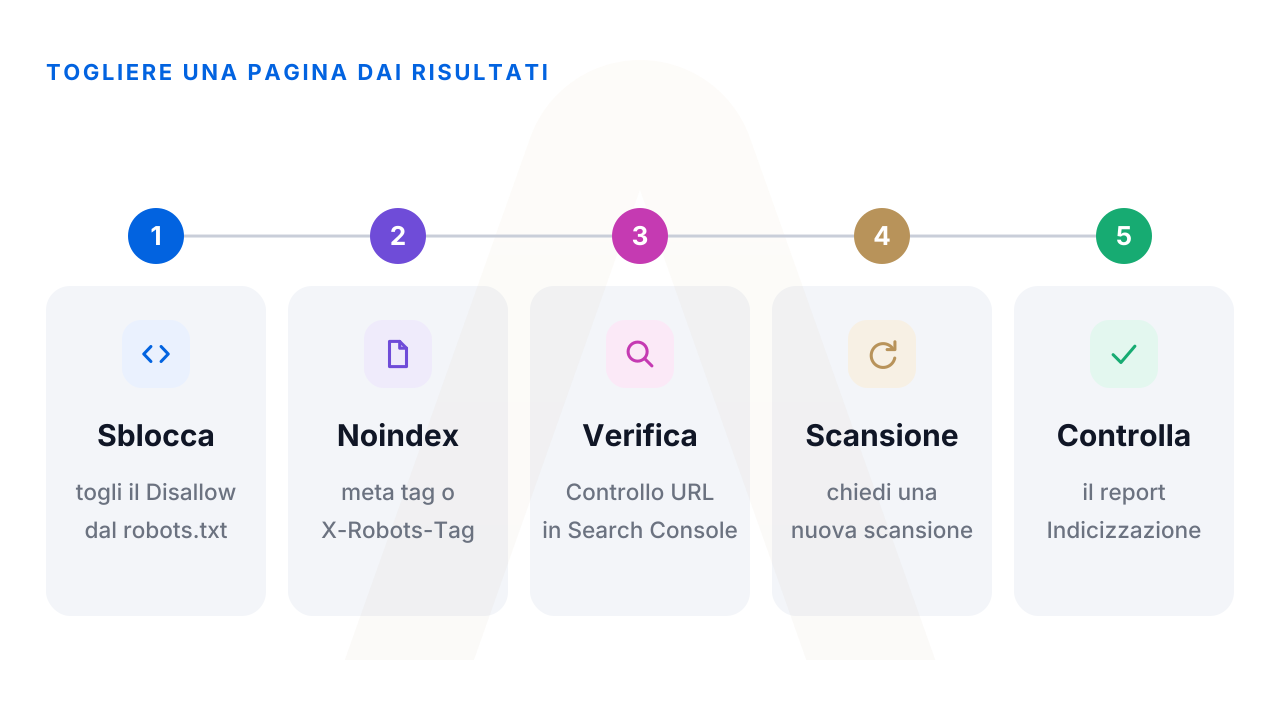
- Togli il blocco Disallow per quell’URL dal robots.txt.
- Aggiungi il noindex con il meta tag o, per i file non HTML, con l’X-Robots-Tag.
- Verifica la pagina con lo strumento Controllo URL di Search Console.
- Chiedi una nuova scansione dallo stesso strumento.
- Controlla nel report Indicizzazione delle pagine che l’URL risulti escluso.
Google applica il noindex alla scansione successiva, che per le pagine meno importanti può arrivare anche dopo mesi. Se la pagina deve sparire subito dai risultati, per esempio perché contiene dati riservati, usa lo strumento Rimozioni di Search Console, che la nasconde temporaneamente mentre il noindex fa effetto. Per un link di un altro sito con informazioni personali superate la strada è invece il diritto all’oblio, con il modulo di Google per le richieste europee.
Cos’è l’X-Robots-Tag e Quando si Usa?
L’X-Robots-Tag è un’intestazione HTTP che accetta gli stessi valori del tag HTML. Si usa per i file che non hanno un <head>, come PDF, documenti e immagini. Si imposta nella configurazione del server:
X-Robots-Tag: noindex, nofollowSu Apache e NGINX la regola si scrive nel file di configurazione del server, di solito per tutti i file di un certo tipo. L’arrivo dell’intestazione si verifica negli strumenti per sviluppatori di Chrome: pannello Rete, intestazioni della risposta.
Come Verificare se una Pagina Ha il Noindex?
Il controllo più rapido è nel codice: apri il sorgente della pagina e cerca "robots"; per i file non HTML guarda le intestazioni della risposta. Il punto di vista di Google si legge invece in Search Console, lo strumento che elenca le pagine non indicizzate con il motivo:
- Controllo URL: la voce "Indicizzazione consentita?" mostra se la pagina ha un noindex; "Testa URL pubblicato" controlla la versione online e "Richiedi indicizzazione" chiede una nuova scansione.
- Report Indicizzazione delle pagine: elenca gli URL esclusi con lo stato "URL contrassegnato con ‘noindex’".
Se hai visto messaggi come "Esclusa in base al tag noindex" o "L’URL inviato contiene un tag noindex", il problema è lo stesso: una pagina che vuoi nei risultati ha un noindex da togliere.
Quali Errori Evitare con il Meta Tag Robots?
Il tag è semplice e per questo facile da usare male: un noindex dimenticato può togliere dai risultati un intero sito.
- Noindex e Disallow insieme: il blocco nel robots.txt impedisce a Google di leggere il noindex.
- Noindex rimasto dallo staging: durante una migrazione del sito il noindex della versione di prova passa in produzione e toglie pagine dai risultati.
- L’opzione di WordPress dimenticata attiva: "Scoraggia i motori di ricerca dall’effettuare l’indicizzazione di questo sito" aggiunge noindex, nofollow a tutte le pagine; controllarla è una delle verifiche di base della SEO per WordPress.
- Noindex tolto con JavaScript: se Google trova il noindex nel codice iniziale può saltare il rendering, quindi la modifica fatta via JavaScript, come spiega la guida di Google alla SEO per JavaScript, può non arrivare.
- Noindex per i duplicati: per scegliere la versione principale di un contenuto serve il canonical.
- Regole diverse tra tema e plugin: due tag robots con istruzioni diverse nella stessa pagina; vale la più restrittiva, anche se nessuno se ne accorge.
Il Controllo da Ripetere Dopo Ogni Rilascio
Questi errori possono nascere in un momento preciso: un rilascio, una migrazione, l’aggiornamento di un tema o di un plugin. Dopo ciascuno di questi passaggi conviene riaprire le pagine principali in Controllo URL e scorrere il report Indicizzazione delle pagine alla ricerca di esclusioni per noindex che nessuno ha deciso. Il robots.txt resta lo strumento della scansione; al meta tag spetta l’indice.
Direttive robots e pagine escluse dall’indice rientrano tra i primi controlli di un audit SEO: chi ha appena cambiato piattaforma o tema e vuole un riscontro esterno può contattarci prima che il calo si veda nel traffico.
Domande Frequenti sul Meta Tag Robots
Come non far indicizzare una pagina da Google?
Aggiungi il tag robots con noindex nel <head> della pagina, oppure l’intestazione X-Robots-Tag: noindex per i file non HTML; poi lascia la pagina scansionabile nel robots.txt. In alternativa puoi proteggerla con una password.
Cosa significa noindex, nofollow?
Chiede ai motori di ricerca di non mostrare la pagina nei risultati e di non seguire i link che contiene. Equivale alla regola none ed è tipica delle pagine che non devono comparire, come un’area riservata.
Serve scrivere index, follow nel meta tag robots?
No. Senza indicazioni Google considera la pagina indicizzabile e i suoi link seguibili: il valore predefinito è all, cioè nessuna restrizione.
Il noindex nel robots.txt funziona?
No. Google non supporta il noindex nel robots.txt dal 1° settembre 2019: va inserito nel meta tag o nell’intestazione HTTP X-Robots-Tag.
Quanto ci mette una pagina con noindex a sparire da Google?
Dipende da quando Googlebot torna sulla pagina: per le pagine meno importanti possono servire mesi. Puoi chiedere una nuova scansione con lo strumento Controllo URL e, in caso di urgenza, nascondere la pagina con lo strumento Rimozioni di Search Console.
Perché Google non indicizza il mio sito?
Una possibile causa è un noindex attivo per errore, per esempio l’opzione di WordPress che scoraggia i motori di ricerca, oppure un blocco nel robots.txt. Il report Indicizzazione delle pagine di Search Console indica il motivo per ogni URL.
Il meta tag robots può escludere i contenuti dalle AI Overview?
In parte sì: nosnippet impedisce che il testo venga usato come input diretto per le AI Overview e la Modalità AI, max-snippet ne limita la quantità e noindex esclude la pagina dalla Ricerca.
Che differenza c’è tra meta robots nofollow e rel="nofollow"?
Il meta tag vale per tutti i link della pagina, l’attributo rel="nofollow" per il singolo link. Dal 1° marzo 2020 Google tratta l’attributo come un suggerimento e gli affianca rel="sponsored" per i link a pagamento e rel="ugc" per i contenuti degli utenti.
Iscriviti alla newsletter
Ricevi la newsletter via email. Puoi disiscriverti quando vuoi.