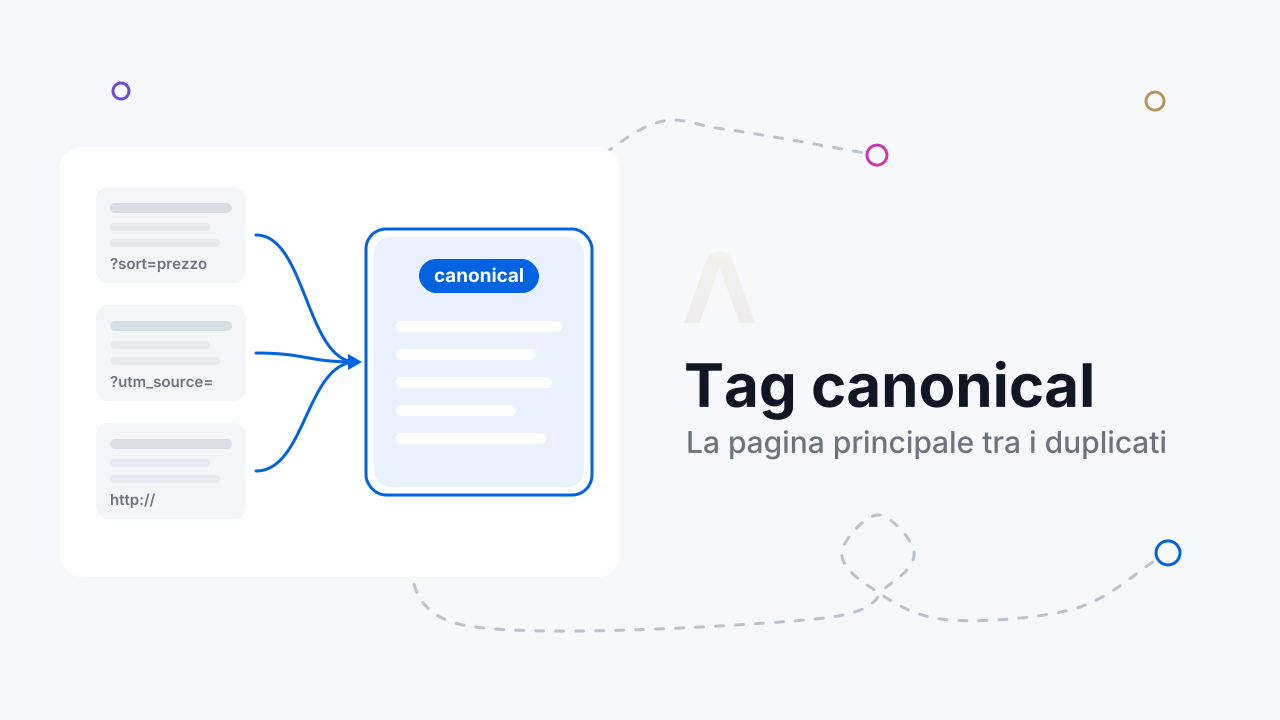
Cos’è il tag canonical e perché Google a volte lo ignora? È un elemento <link rel="canonical">, inserito nel <head> di una pagina o inviato come intestazione HTTP, con cui indichi quale URL considerare principale tra pagine duplicate o molto simili. Per Google è un segnale forte ma resta un suggerimento: la scelta finale della pagina canonica spetta a Google.
Il tag canonical in breve
- Cos’è: un’indicazione dell’URL preferito tra più versioni dello stesso contenuto.
- Dove si mette: nel
<head>della pagina HTML, oppure nell’intestazione HTTPLinkper PDF e altri file. - Forza: per la guida di Google è un indicatore forte come il redirect, che però viene prima; la sitemap è un indicatore debole.
- Canonical autoreferenziale: Google raccomanda di inserirlo anche sulla pagina canonica stessa.
- Quando viene ignorato: con più canonical nella stessa pagina, se sta nel
<body>o se il contenuto delle pagine non è simile. - Tempi: dopo una correzione Google può tenere le pagine nel gruppo di duplicati fino a due settimane.
- Riferimento: RFC 6596, documento informativo pubblicato dall’IETF nell’aprile 2012.
Cos’è il tag canonical?
Il canonical è l’annotazione con cui un sito dichiara a Google la versione principale di un contenuto disponibile su più URL. Google chiama canonicalizzazione il processo con cui sceglie l’URL rappresentativo di un gruppo di pagine duplicate: raggruppa le pagine con contenuto principale uguale o molto simile e ne indicizza una, scansionando le altre meno spesso.
Google ha annunciato il supporto al canonical il 12 febbraio 2009. Nell’aprile 2012 l’IETF ha pubblicato la RFC 6596, un documento informativo che descrive la relazione canonical. Il nome ricorre anche in altri contesti: a settembre 2026 su Google Italia la ricerca "canonical" restituiva soprattutto l’azienda che sviluppa Ubuntu, motivo per cui chi cerca informazioni SEO scrive di solito "tag canonical" o "rel canonical".
Audit SEO
Audit SEO tecnico per siti ed e-commerce, con gli interventi ordinati per impatto.
A cosa serve il canonical e quando è necessario?
Il canonical serve a scegliere quale URL compare nei risultati, a concentrare su una sola pagina segnali come i link e a evitare che Google spenda scansioni su versioni inutili. La guida di Google elenca alcune situazioni in cui nascono i duplicati:
- Parametri e funzioni del sito: ordinamento e filtri di una categoria, parametri di tracciamento come
?gclid=. - Protocollo e dominio: versioni HTTP e HTTPS, con e senza www.
- Dispositivo: versioni mobile e desktop su URL separati.
- Varianti regionali nella stessa lingua: per esempio pagine per Stati Uniti e Regno Unito con lo stesso testo.
- Versioni accidentali: un ambiente di test lasciato accessibile ai crawler.
Nessuna regola rende obbligatorio il canonical: Google scrive, nella guida ai metodi di canonicalizzazione, che senza indicazioni sceglie da sé la versione migliore e che un certo livello di contenuti duplicati è normale e non viola le norme sullo spam. Dichiararlo conviene quando vuoi decidere tu quale URL mostrare e misurare, invece di lasciarlo a Google.
Come si scrive il tag canonical?
Il canonical si scrive come elemento <link> nel <head> della pagina duplicata, con l’URL completo della pagina canonica. Questo è l’esempio della documentazione di Google:
<head>
  <title>Explore the world of dresses</title>
  <link rel="canonical" href="https://example.com/dresses/green-dresses" />
</head>
Google consiglia gli URL assoluti. Quelli relativi sono supportati ma rischiosi: se un ambiente di test viene scansionato per errore, un canonical relativo punta alle pagine di test invece che a quelle del sito pubblico. Anche un URL scritto senza protocollo, come example.com/pagina.html, viene letto come relativo e produce un indirizzo sbagliato.
Come si mette il canonical su un PDF?
PDF, documenti e altri file privi di <head> ricevono il canonical nell’intestazione HTTP della risposta. Google lo supporta per i risultati della ricerca web:
Link: <https://www.example.com/downloads/white-paper.pdf>; rel="canonical"Google raccomanda di usare un solo metodo per pagina: elemento HTML oppure intestazione HTTP. Usarli entrambi è supportato, ma aumenta il rischio che i due valori divergano dopo una modifica.
Serve il canonical autoreferenziale?
Sì, la guida di Google lo raccomanda: la pagina canonica deve contenere un canonical che punta a sé stessa. Il canonical autoreferenziale protegge la pagina dalle sue varianti con parametri, perché un URL con parametri UTM come /scarpe/?utm_source=newsletter eredita lo stesso tag e indica come principale la versione pulita.
Funziona però solo se punta proprio all’URL che vuoi indicizzare.
Che differenza c’è tra canonical, redirect 301, noindex e sitemap?
Sono strumenti con effetti diversi, che Google ordina per forza nella sua guida alla gestione degli URL duplicati. Il redirect e il canonical sono entrambi segnali forti, con il redirect al primo posto; la presenza nella sitemap è un segnale debole; il noindex e il robots.txt non vanno usati per scegliere la pagina canonica.
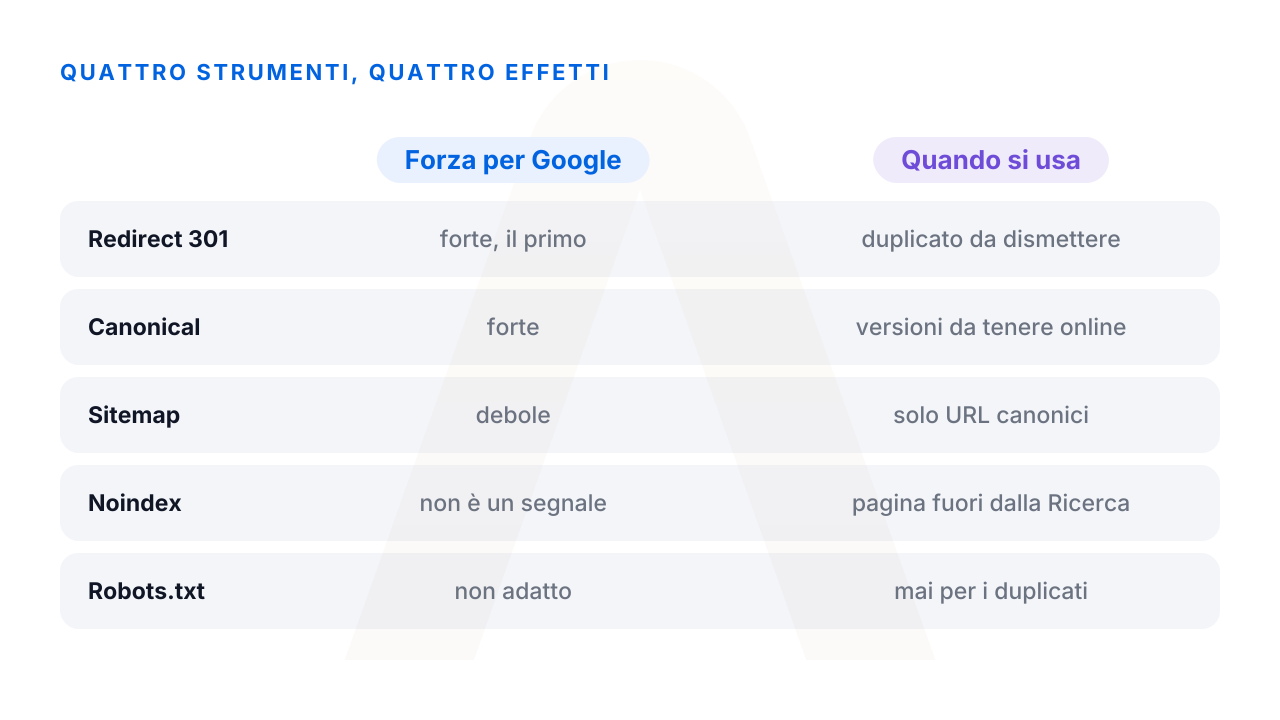
- Redirect 301 o 308: da usare quando dismetti un duplicato, per esempio nel passaggio da HTTP a HTTPS o da un vecchio URL a uno nuovo; l’utente non vede più la pagina di partenza.
- Canonical: da usare quando le versioni devono restare accessibili, come le pagine filtrate, quelle con parametri di campagna o le varianti di un A/B testing con URL propri.
- Sitemap: un rinforzo; tutti gli URL elencati sono suggeriti come canonici, per questo deve contenere solo le versioni principali.
- Noindex: toglie la pagina dalla Ricerca, come spiegato nella guida al meta tag robots; per i duplicati interni al sito Google preferisce il canonical.
I segnali si sommano quando puntano allo stesso URL e si contraddicono quando puntano a URL diversi. Una pagina indicata come canonica nel <head> e sostituita da un’altra nella sitemap manda a Google due risposte diverse alla stessa domanda.
Perché Google può ignorare il canonical?
Google può ignorare il canonical quando la dichiarazione è tecnicamente invalida o quando le pagine non sono duplicate nella sostanza. Nella guida alla risoluzione dei problemi scrive che anche con un canonical esplicito può scegliere un’altra pagina per la qualità del contenuto o per altri segnali tecnici.
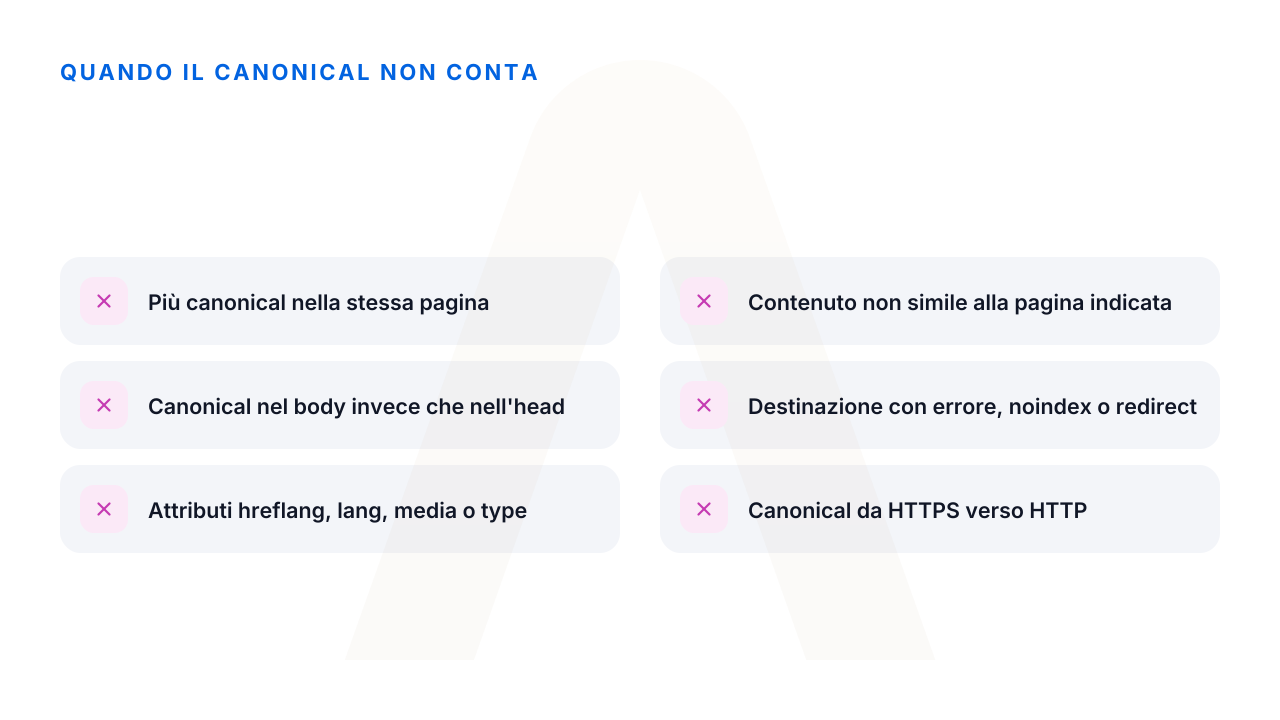
- Più canonical nella stessa pagina: la guida di Google a JavaScript avverte che canonical multipli o in conflitto possono causare risultati imprevisti. Può succedere quando tema e plugin SEO inseriscono ciascuno il proprio tag, o quando uno script ne aggiunge un secondo.
- Canonical nel
<body>: viene accettato solo nel<head>, che deve essere HTML valido. - Attributi aggiuntivi: un canonical con hreflang, lang, media o type non vale per la canonicalizzazione; per le versioni alternative si usa
rel="alternate". - Contenuti diversi: Google non accetta come canonica una pagina con un contenuto diverso da quella che la indica.
- Destinazione non valida: se la pagina indicata è un errore, un soft 404 o ha un noindex, il canonical rischia di essere ignorato, come avvertiva Google nel post del 2013 sugli errori comuni.
- HTTPS verso HTTP: un canonical dalla versione HTTPS a quella HTTP, o un certificato non valido, fanno preferire a Google la versione HTTP.
La stessa guida documenta anche il caso dei siti compromessi, in cui un attacco inserisce nel <head> o nell’intestazione HTTP un canonical verso siti di spam. Un controllo periodico dei canonical sull’HTML servito ai crawler permette di accorgersi di questo tipo di manomissione.
Il canonical su paginazione, filtri e parametri
Nella paginazione ogni pagina deve avere il proprio canonical: la guida di Google alla paginazione chiede di non usare la prima pagina di una sequenza come canonica delle successive. Se la pagina 2 di una categoria punta alla pagina 1, il contenuto della pagina 2 può essere scartato come duplicato. La RFC 6596 dice la stessa cosa e ammette un’eccezione: le pagine di una serie possono indicare come canonica una pagina "mostra tutti", che contiene l’intero elenco.
Per i filtri della navigazione a faccette e gli ordinamenti la scelta dipende dal catalogo. Le combinazioni senza valore di ricerca si canonicalizzano sulla categoria o si escludono, mentre quelle che intercettano una domanda di ricerca, come la combinazione di categoria e marca, possono meritare un URL indicizzabile con il proprio canonical. È una delle decisioni di impianto della consulenza SEO ecommerce, perché incide sull’indice di migliaia di pagine con una sola regola del template.
Canonical, hreflang e JavaScript
Con le versioni linguistiche la pagina canonica va indicata nella stessa lingua o, se non esiste, nella migliore lingua sostitutiva, come chiede la guida di Google. Google considera duplicate due lingue solo se il contenuto principale è nella stessa lingua, per esempio quando sono tradotti soltanto intestazione e piè di pagina.
Nei progetti di SEO internazionale le varianti regionali nella stessa lingua richiedono insieme canonical e hreflang, perché il primo sceglie la pagina e il secondo indica a quale paese è destinata.
Con JavaScript la regola di Google è semplice: il canonical va nell’HTML originale e lo script non deve cambiarlo. Se non si può inserire nell’HTML, si imposta solo con JavaScript e deve essere l’unico della pagina. Un framework che aggiunge un secondo canonical durante il rendering ricade nel caso dei canonical multipli visto sopra.
Il canonical può puntare a un altro dominio?
Sì, la RFC 6596 lo prevede e Google lo supporta, per esempio quando un contenuto è stato spostato su un altro dominio e non si possono impostare redirect lato server. Sui contenuti ripubblicati da altri siti, invece, Google e Bing danno indicazioni diverse.
- Google: per la syndication il canonical è sconsigliato nella guida ai problemi di canonicalizzazione, perché le pagine ripubblicate sono spesso molto diverse dall’originale; il post del 2009 che introduceva il canonical tra domini oggi riporta questa avvertenza. La soluzione indicata è che i partner blocchino l’indicizzazione della copia.
- Bing: in un articolo del 19 dicembre 2025 suggerisce di chiedere ai partner un canonical verso l’originale, quando gli accordi lo consentono, oppure di ripubblicare solo estratti con un link alla fonte.
In pratica, l’accordo con chi ripubblica va scritto pensando al motore che conta di più per il sito. Se il traffico arriva soprattutto da Google, il noindex sulla copia è la soluzione allineata alla sua documentazione.
Come si controlla il canonical in Search Console?
Lo strumento Controllo URL mostra due valori: il "Contenuto canonico dichiarato dall’utente" (quello del tag) e il "Contenuto canonico selezionato da Google". Se coincidono, la dichiarazione è stata accettata; se sono diversi, Google ha scelto un’altra pagina.
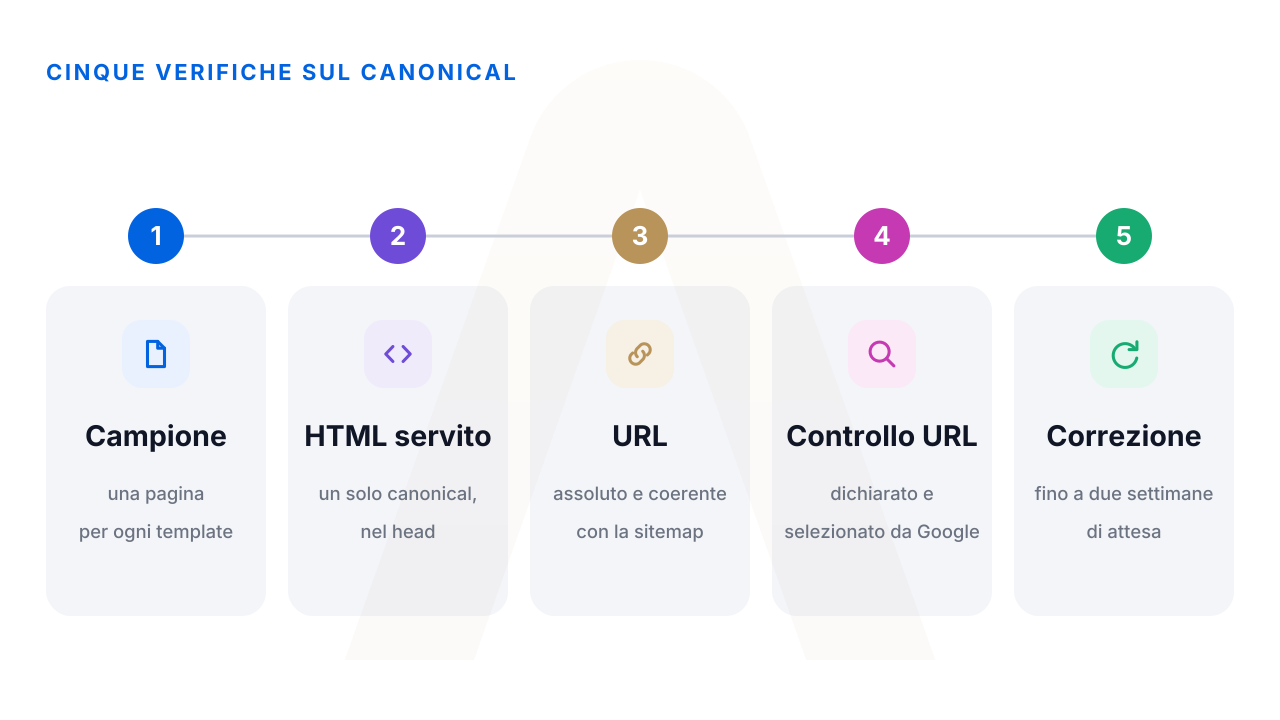
Il test sulla versione pubblicata non può prevedere quale pagina diventerà canonica: la scelta avviene solo al momento dell’indicizzazione. Dopo una correzione Google può tenere le pagine nel gruppo di duplicati fino a due settimane; la richiesta di indicizzazione, poi, ha una quota: conviene usarla solo per gli URL importanti. La guida alle pagine non indicizzate spiega uno per uno i tre stati del report legati ai duplicati e cosa fare in ciascun caso.
Quando il canonical sbagliato sta nel template
Un canonical scritto male dal template si ripete su tutte le pagine dello stesso tipo, che siano centinaia di schede prodotto o tutte le combinazioni di filtri di una categoria. Per questo il controllo, come gli altri controlli di SEO on page, ha senso per modelli di pagina: home, categorie, schede prodotto o servizio, articoli e pagine con parametri, ciascuno con il suo esempio nell’HTML servito e il suo confronto nel Controllo URL.
Un audit SEO lavora proprio così, analizzando il sito per gruppi di URL. Se il valore dichiarato e quello selezionato da Google non coincidono su più modelli di pagina, la verifica si può affidare a noi prima di mettere mano al template.
Domande frequenti sul tag canonical
Il canonical è obbligatorio?
No. Nessun metodo di canonicalizzazione è obbligatorio: senza indicazioni, Google sceglie da sé la versione migliore da mostrare. Conviene dichiararlo quando esistono duplicati e vuoi decidere tu quale URL mostrare.
Google rispetta sempre il canonical?
No. È un suggerimento: Google può scegliere un’altra pagina per la qualità del contenuto o per altri segnali tecnici. Non sceglie mai come canonica una pagina il cui contenuto non è simile a quella che la indica.
Serve il canonical autoreferenziale?
Sì. Anche la pagina canonica deve contenere un canonical che punta a sé stessa. Protegge la pagina dalle sue varianti con parametri di tracciamento o di ordinamento, che ereditano lo stesso tag.
Il canonical può puntare a un altro dominio?
Sì, la RFC 6596 lo prevede e Google lo supporta. Per i contenuti ripubblicati da altri siti, però, Google lo sconsiglia e indica di bloccare l’indicizzazione della copia, mentre Bing suggerisce il canonical verso l’originale quando gli accordi lo consentono.
Si possono usare canonical e noindex insieme?
Non per scegliere la pagina canonica: il noindex toglie la pagina dalla Ricerca; la pagina indicata come canonica non deve avere un noindex. Per i duplicati interni al sito la soluzione preferita è il canonical.
Cosa significa Pagina alternativa con tag canonical appropriato?
Si tratta di uno stato del report di Search Console sull’indicizzazione delle pagine: la pagina indica correttamente una versione canonica già indicizzata, per esempio una versione mobile o AMP che rimanda a quella per computer. Non serve fare nulla.
Come si mette il canonical su un PDF?
Con l’intestazione HTTP Link, indicando l’URL canonico assoluto e rel="canonical", perché l’elemento link funziona solo nelle pagine HTML. Questo metodo vale per i risultati della ricerca web di Google, anche per documenti Word e altri file non HTML.
Quanto tempo serve perché Google cambi la pagina canonica?
Dopo la correzione Google può tenere le pagine nel gruppo di duplicati fino a due settimane; si separano prima se la differenza tra le pagine è chiara. Per gli URL importanti si può poi chiedere l’indicizzazione.
Iscriviti alla newsletter
Ricevi la newsletter via email. Puoi disiscriverti quando vuoi.